Stable Diffusion Illustrata
La capacità dell’ AI di creare immagini sorprendenti partendo da descrizioni testuali ai più potrebbe cambiare per sempre quello che è per noi l’arte visuale. Gli studi su Stable Diffusion che hanno portato ad una fgrande ottimizzazione nel metodo di allenamento (training) e il relativo rilascio di codice open source hanno rappresentato una forte accelerazione sulle applicazioni: DALL-E, Midjourney e altre piattaforme di Generative Images sono basate su questi studi anche hanno implementato modelli di addestramento molto più ampi di quelli di default rilasciati da Compvis, Runwayml e Stability AI ( detentori dei diritti sui modelli addestrati ) .
Con questo articolo vorrei spiegare alcuni fondamenti che stanno alla base di stable diffusion per far capire a chi si appassiona ma non conosce la tecnologia che non si tratta di magia ma solo e soltanto di “matematica”.
Questa è una semplice introduzione al funzionamento della diffusione stabile.
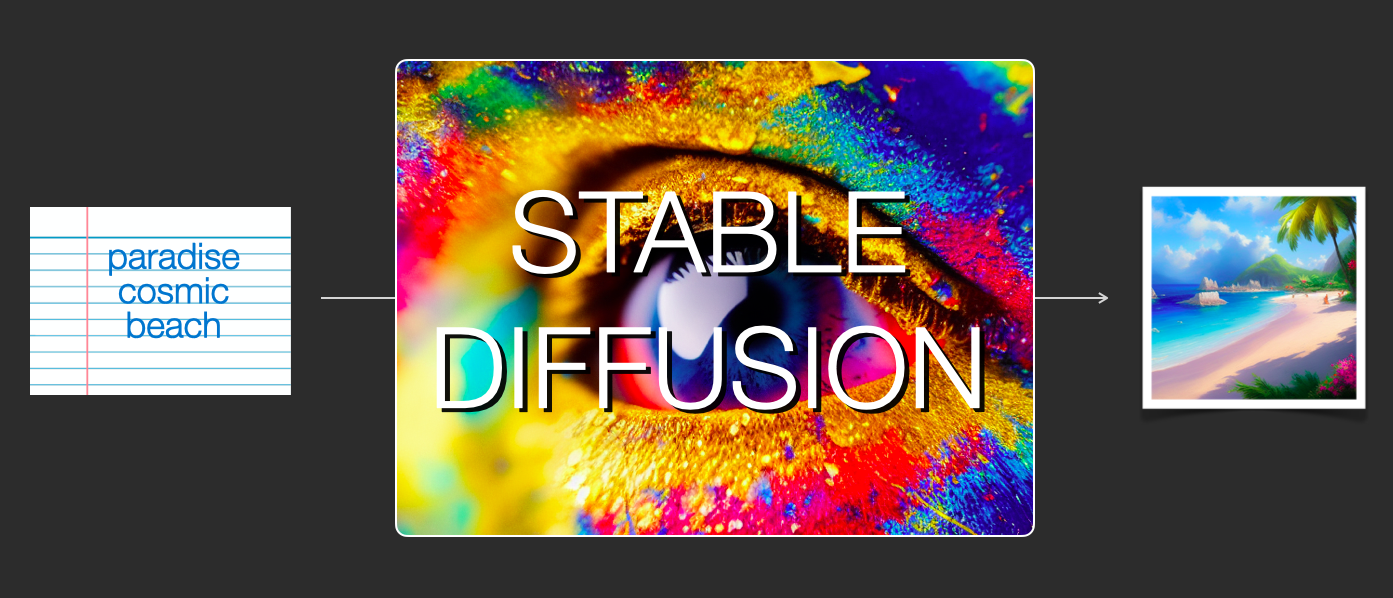
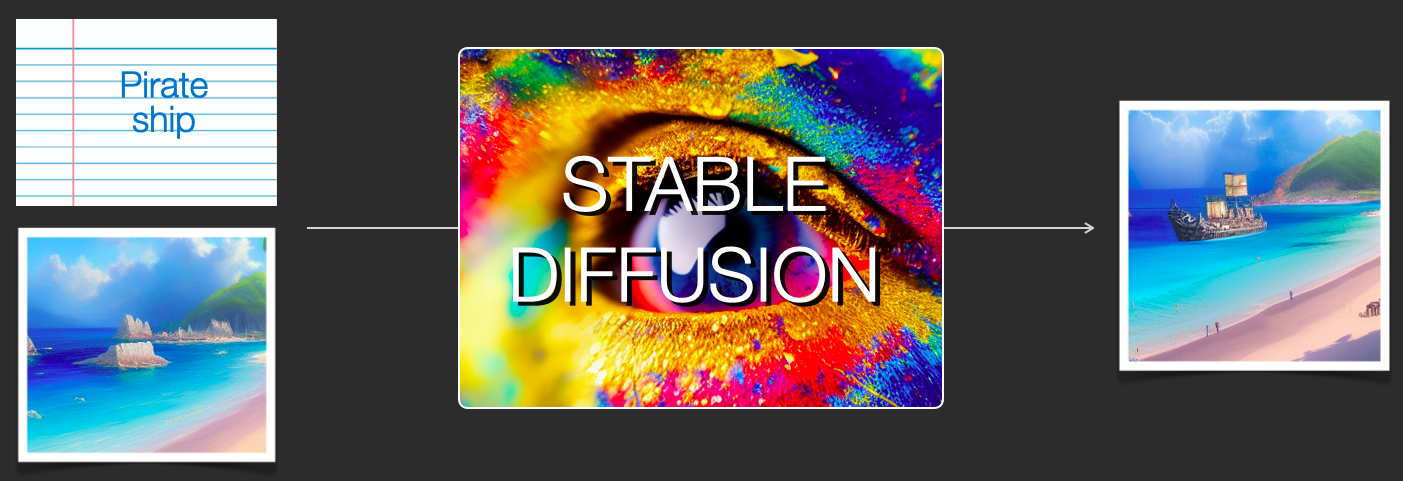
Stable Diffusion è versatile in quanto può essere utilizzato in diversi modi. Concentriamoci inizialmente sulla generazione di immagini dal solo testo (text2img). L’immagine sopra mostra un input di testo di esempio e l’immagine generata risultante (il prompt completo effettivo è qui). A parte il testo in immagine, un altro modo principale di usarlo è quello di alterare le immagini (quindi gli input sono testo + immagine).
Per chi è fortemente appassionato e vuole guardare sotto il cofano comincio con illustrare i principali componenti di Stable Diffusion.
I componenti di Stable Diffusion
SD non è un sistema monolitico ma è composto da più moduli che interagiscono tra loro. Il linguaggio con cui è programmato è Python.
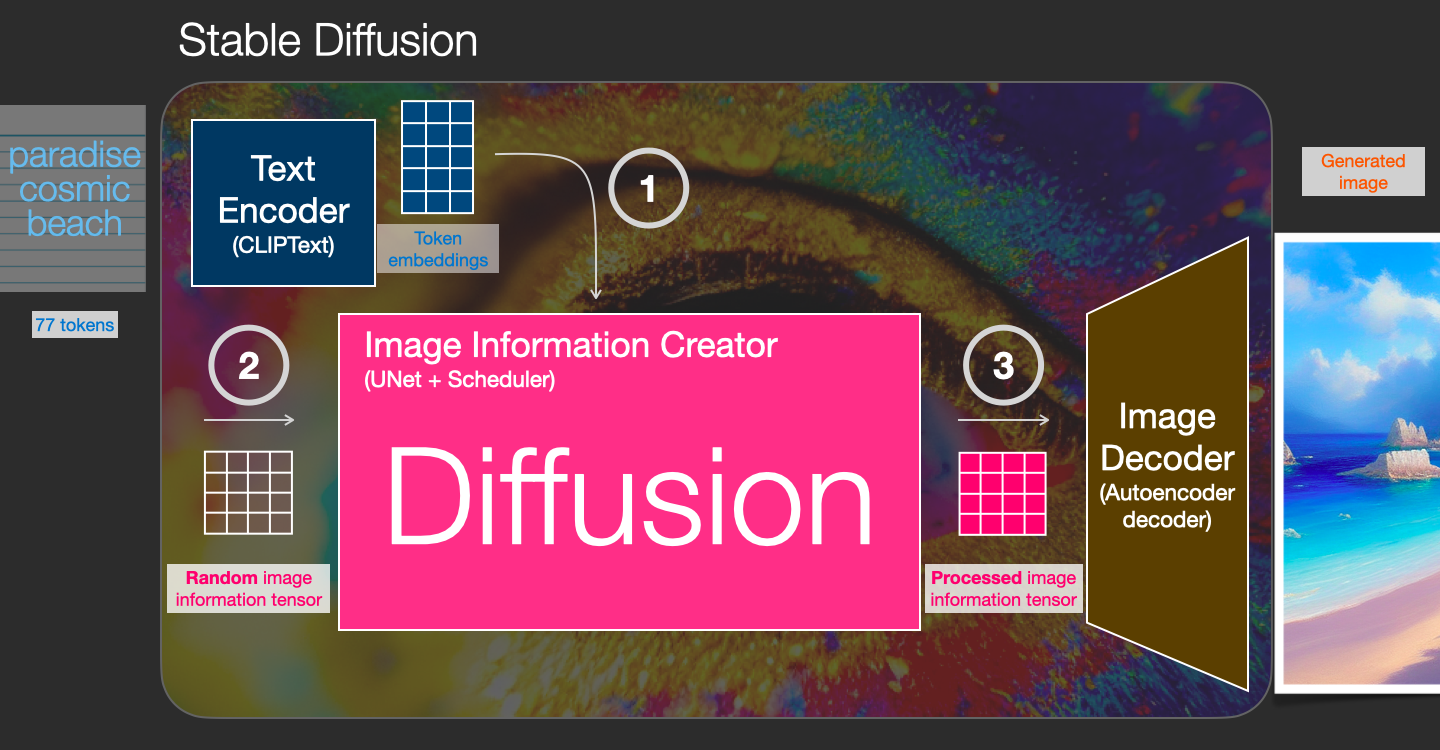
La prima cosa che notiamo è un componente di comprensione del testo che traduce le informazioni del testo in una rappresentazione numerica.
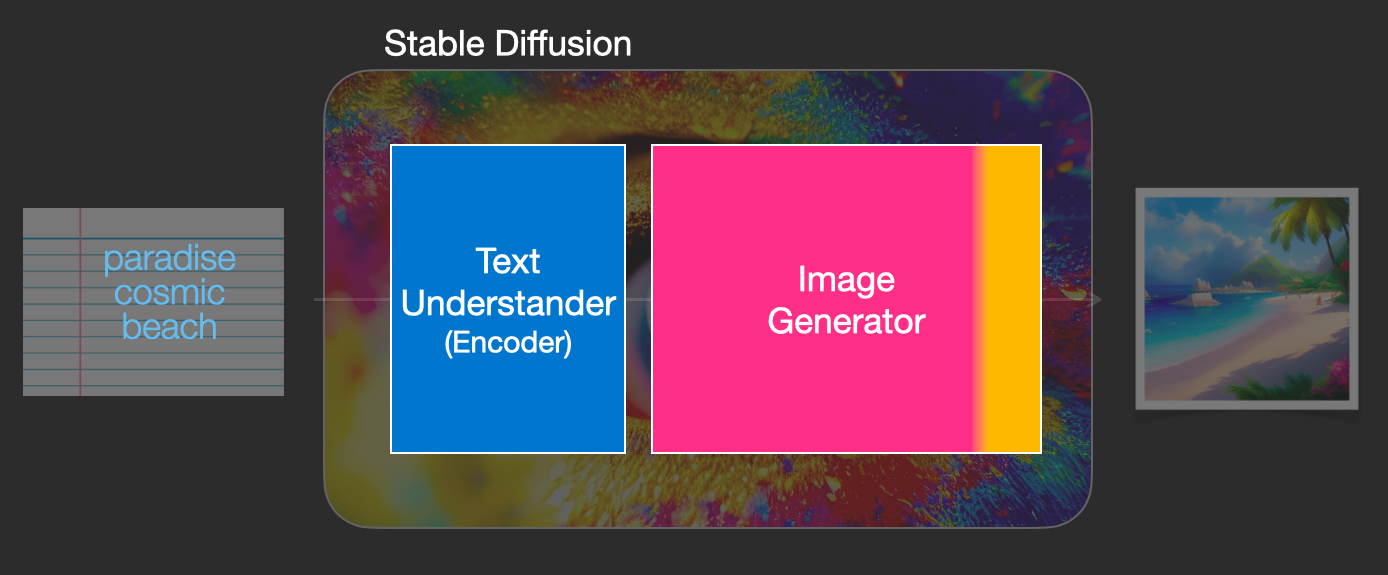
Questo componente si chiama tecnicamente “Transformer” ed è un modulo che interagisce con un modello ( ovvero un insieme di parametri numerici pre-addestrati che istruiscono le reti neuronali nell’effettuare il compito prefissato ). Possiamo anche chiamarlo codificatore anche se questo nome è usato genericamene per tutti i componenti sia visuali che testuali. Il codificatore di testo o Transformer prende il testo di input e restituisce un elenco di numeri ( una matrice o meglio Tensore ) che rappresenta ogni parola (token) del testo (praticamente un vettore per ogni parola). Il modello utilizzato nella prima versone di SD è CLIP di OPENAI ( ovvero lo stesso di ChatGPT). Nelle versone 2 CLIP è stato abbandonato per un nuovo modello chiamato “fantasiosamente” OpenCLIP. Esistono altri modelli come Blip o Bert di Google
La rappresentazione numerica verrà utilizzata in seguito per condizionare la generazione delle immagini che parte sempre da un’immagine pseudo casuale o rumore (noise).
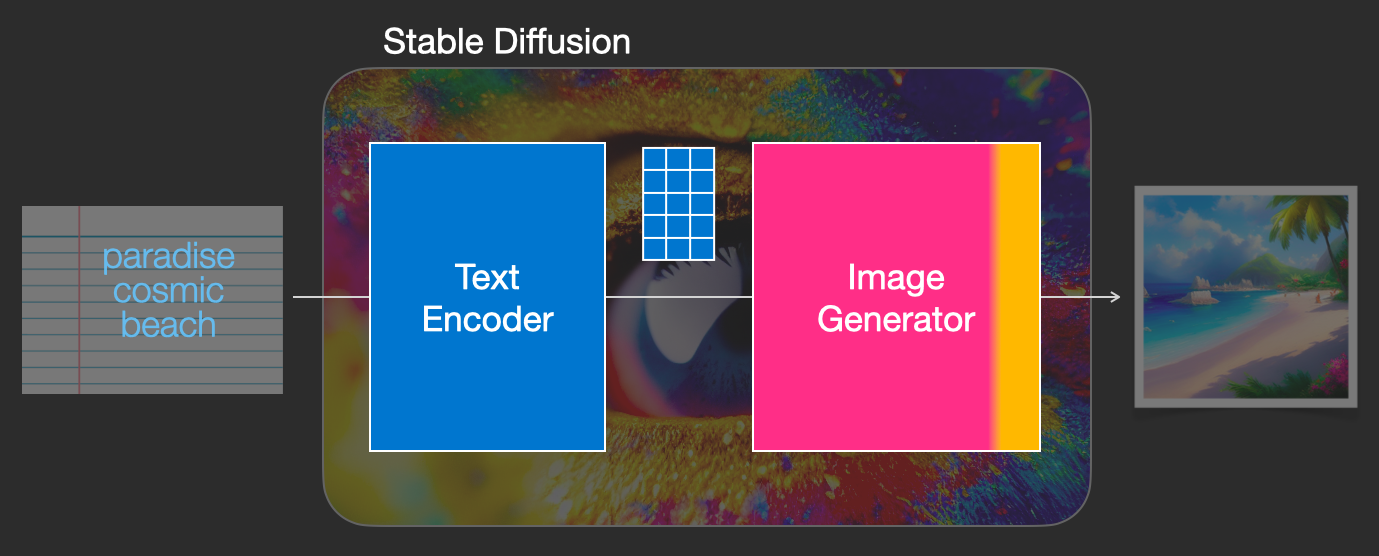
Il generatore di immagini passa attraverso due fasi:
1- Creatore di informazioni sull’immagine
Questo componente è la salsa segreta di Stable Diffusion. È qui che si ottiene gran parte del guadagno in termini di prestazioni rispetto ai modelli precedenti.
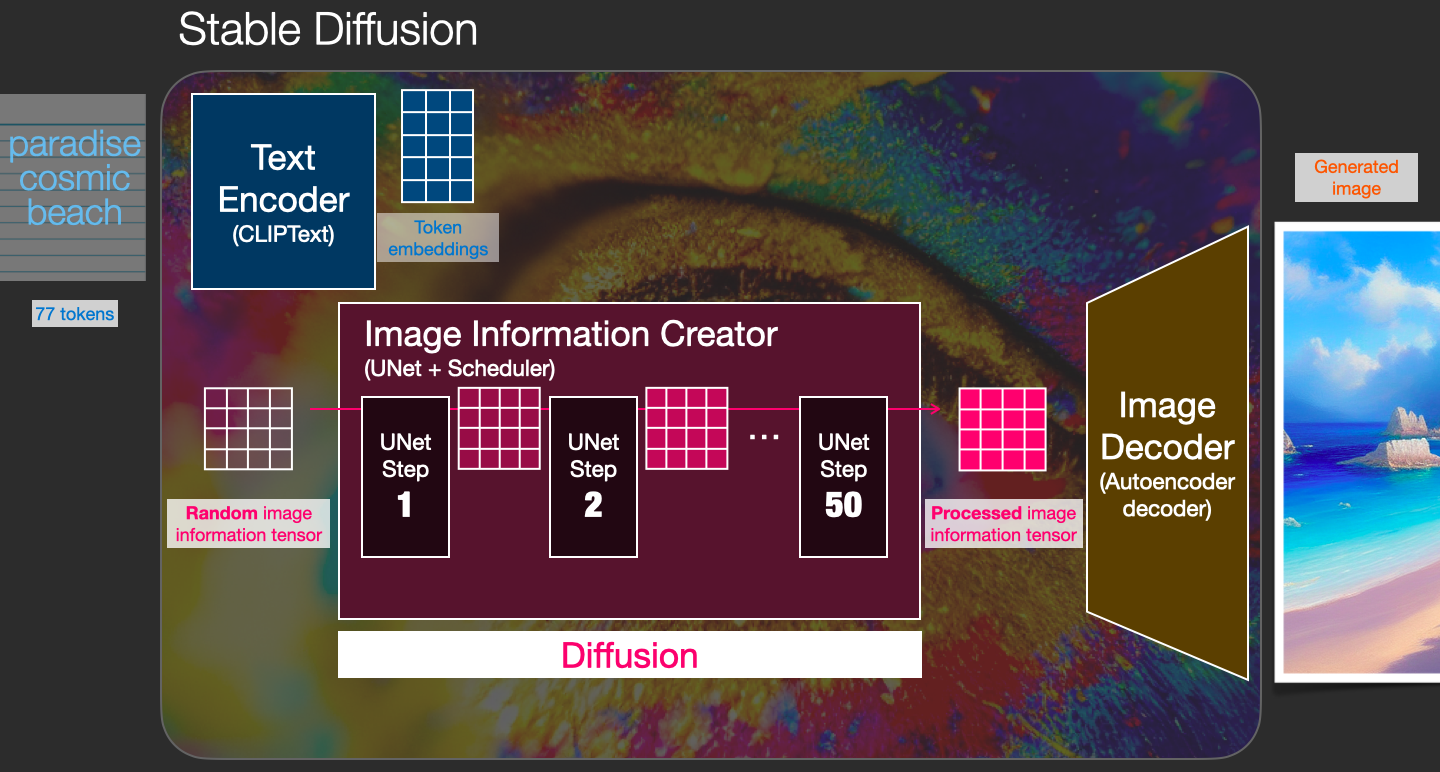
Questo componente viene eseguito per più passaggi per generare informazioni sull’immagine. Questo è il parametro steps nelle interfacce e nelle librerie Stable Diffusion che spesso ha come valore predefinito 50 o 100.
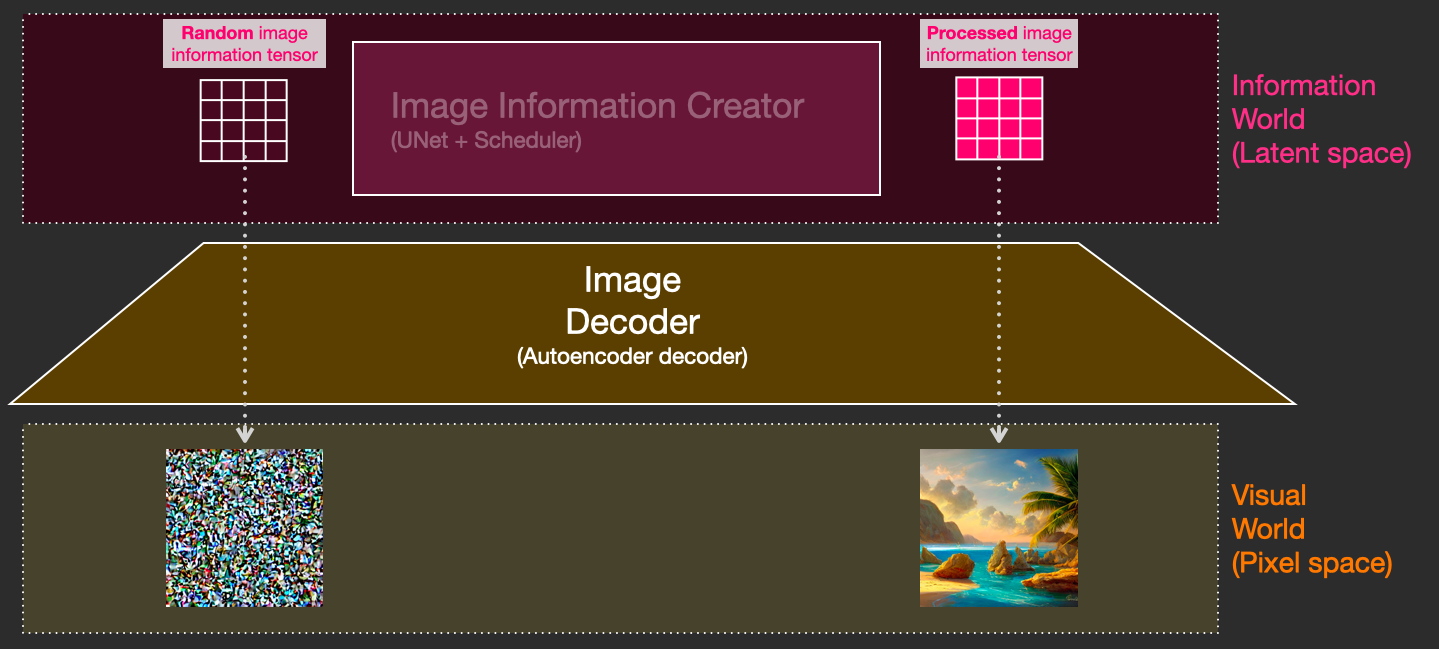
Il creatore di informazioni sull’immagine lavora completamente nello spazio delle informazioni sull’immagine (o spazio latente ). Parleremo di più su cosa significa più avanti nel post. Questa proprietà lo rende più veloce rispetto ai precedenti modelli di diffusione che funzionavano nello spazio dei pixel. In termini tecnici, questo componente è costituito da una rete neurale UNet e da un algoritmo di schedulazione.
La parola “diffusione” descrive ciò che accade in questa componente. È l’elaborazione passo dopo passo delle informazioni che alla fine porta alla generazione di un’immagine di alta qualità (dal componente successivo, il decodificatore di immagini).
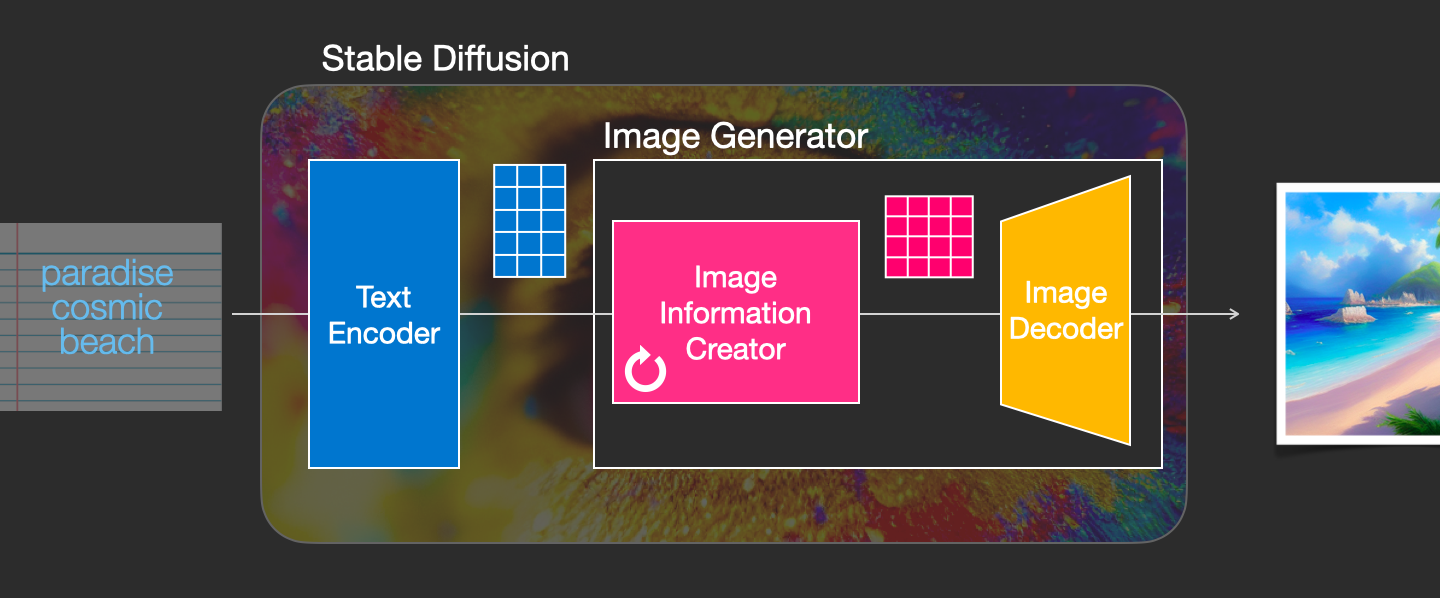
2- Decodificatore di immagini
Il decodificatore di immagini dipinge un’immagine dalle informazioni ottenute dal creatore di informazioni. Viene eseguito solo una volta alla fine del processo per produrre l’immagine pixel finale.
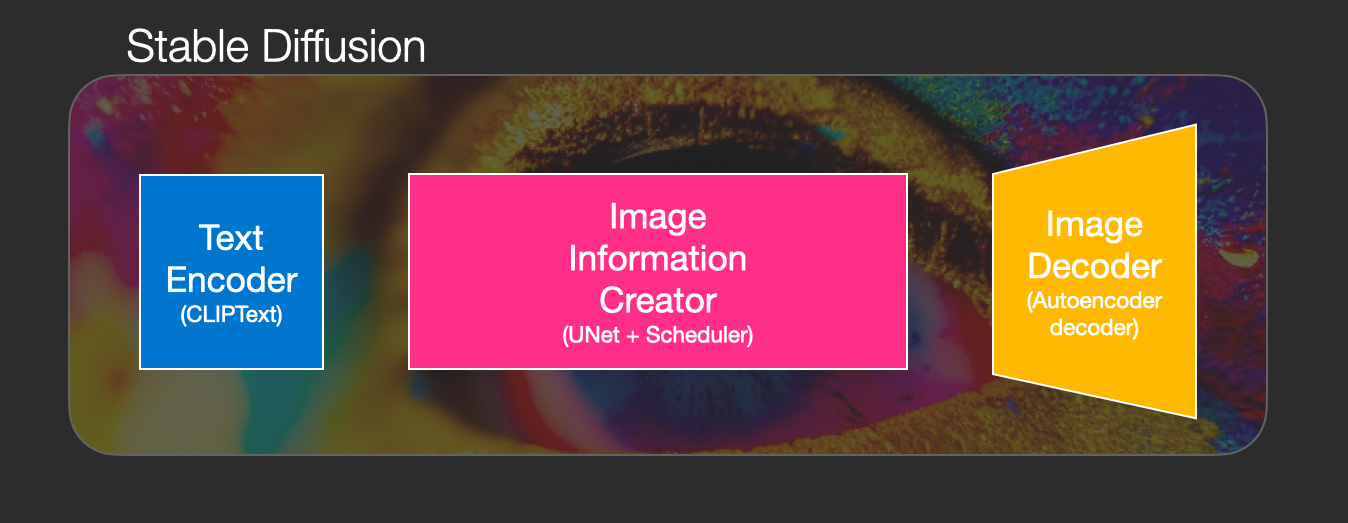
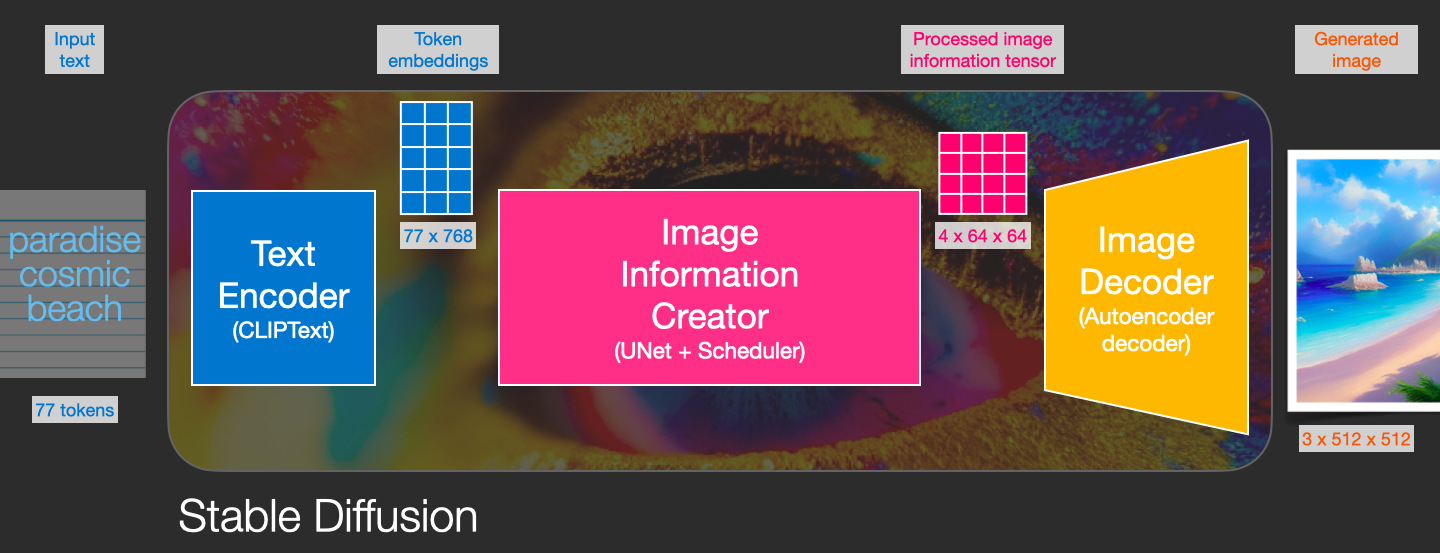
Con questo veniamo a vedere le tre componenti principali (ognuna con la propria rete neurale) che compongono Stable Diffusion:
- ClipText per la codifica del testo.
Testo di input.
Output: 77 vettori di incorporamento di token, ciascuno in 768 dimensioni. - UNet + Scheduler per elaborare/diffondere gradualmente le informazioni nello spazio informativo (latente).
Input: incorporamenti di testo e un array multidimensionale iniziale (elenchi strutturati di numeri, chiamati anche tensor ) costituiti da rumore.
Output: un array di informazioni elaborate - Autoencoder Decoder che dipinge l’immagine finale utilizzando l’array di informazioni elaborate.
Input: l’array delle informazioni elaborate (dimensioni: (4,64,64))
Output: l’immagine risultante (dimensioni: (3, 512, 512) che sono (rosso/verde/blu, larghezza, altezza))
Che cos’è comunque la diffusione?
La diffusione è il processo che avviene all’interno del componente rosa “creatore di informazioni sull’immagine”. Avendo gli incorporamenti di token che rappresentano il testo di input e un array di informazioni sull’immagine iniziale casuale (chiamati anche latents ), il processo produce un array di informazioni che il decodificatore di immagini utilizza per disegnare l’immagine finale.
Questo processo avviene in modo graduale. Ogni passaggio aggiunge informazioni più rilevanti. Per avere un’intuizione del processo, possiamo ispezionare l’array dei lati casuali e vedere che si traduce in rumore visivo. L’ispezione visiva in questo caso lo fa passare attraverso il decodificatore di immagini.
La diffusione avviene in più passaggi, ogni passaggio opera su un array di latenti di input e produce un altro array di latenti che assomiglia meglio al testo di input e a tutte le informazioni visive che il modello ha raccolto da tutte le immagini su cui è stato addestrato il modello.
Possiamo visualizzare un insieme di questi latenti per vedere quali informazioni vengono aggiunte ad ogni passaggio.
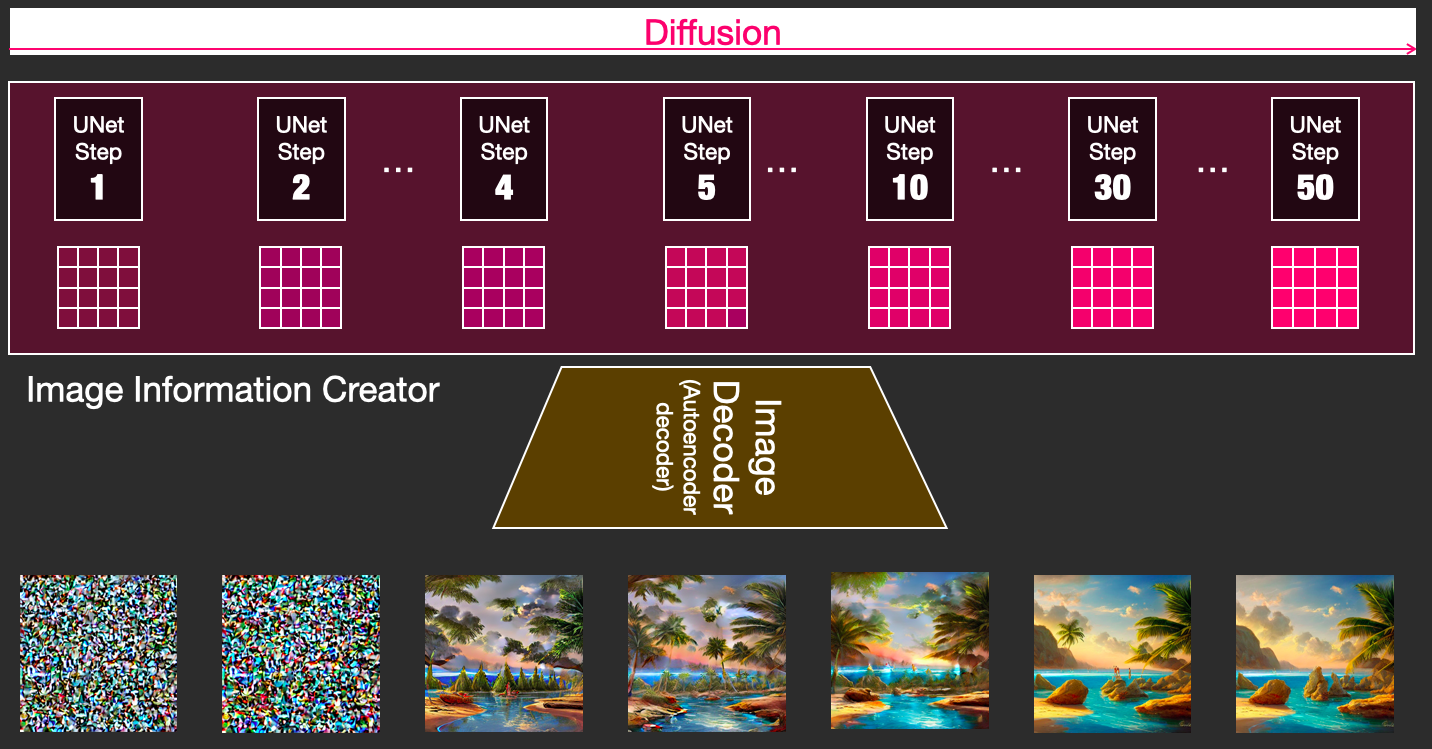
Il processo è piuttosto mozzafiato da guardare.
In questo caso accade qualcosa di particolarmente affascinante tra i passaggi 2 e 4. È come se il contorno emergesse dal rumore.
Come funziona la diffusione
L’idea centrale di generare immagini con modelli di diffusione si basa sul fatto che disponiamo di potenti modelli di visione artificiale. Dato un set di dati sufficientemente ampio, questi modelli possono apprendere operazioni complesse. I modelli di diffusione affrontano la generazione di immagini inquadrando il problema come segue:
Supponiamo di avere un’immagine, generiamo del rumore e lo aggiungiamo all’immagine.
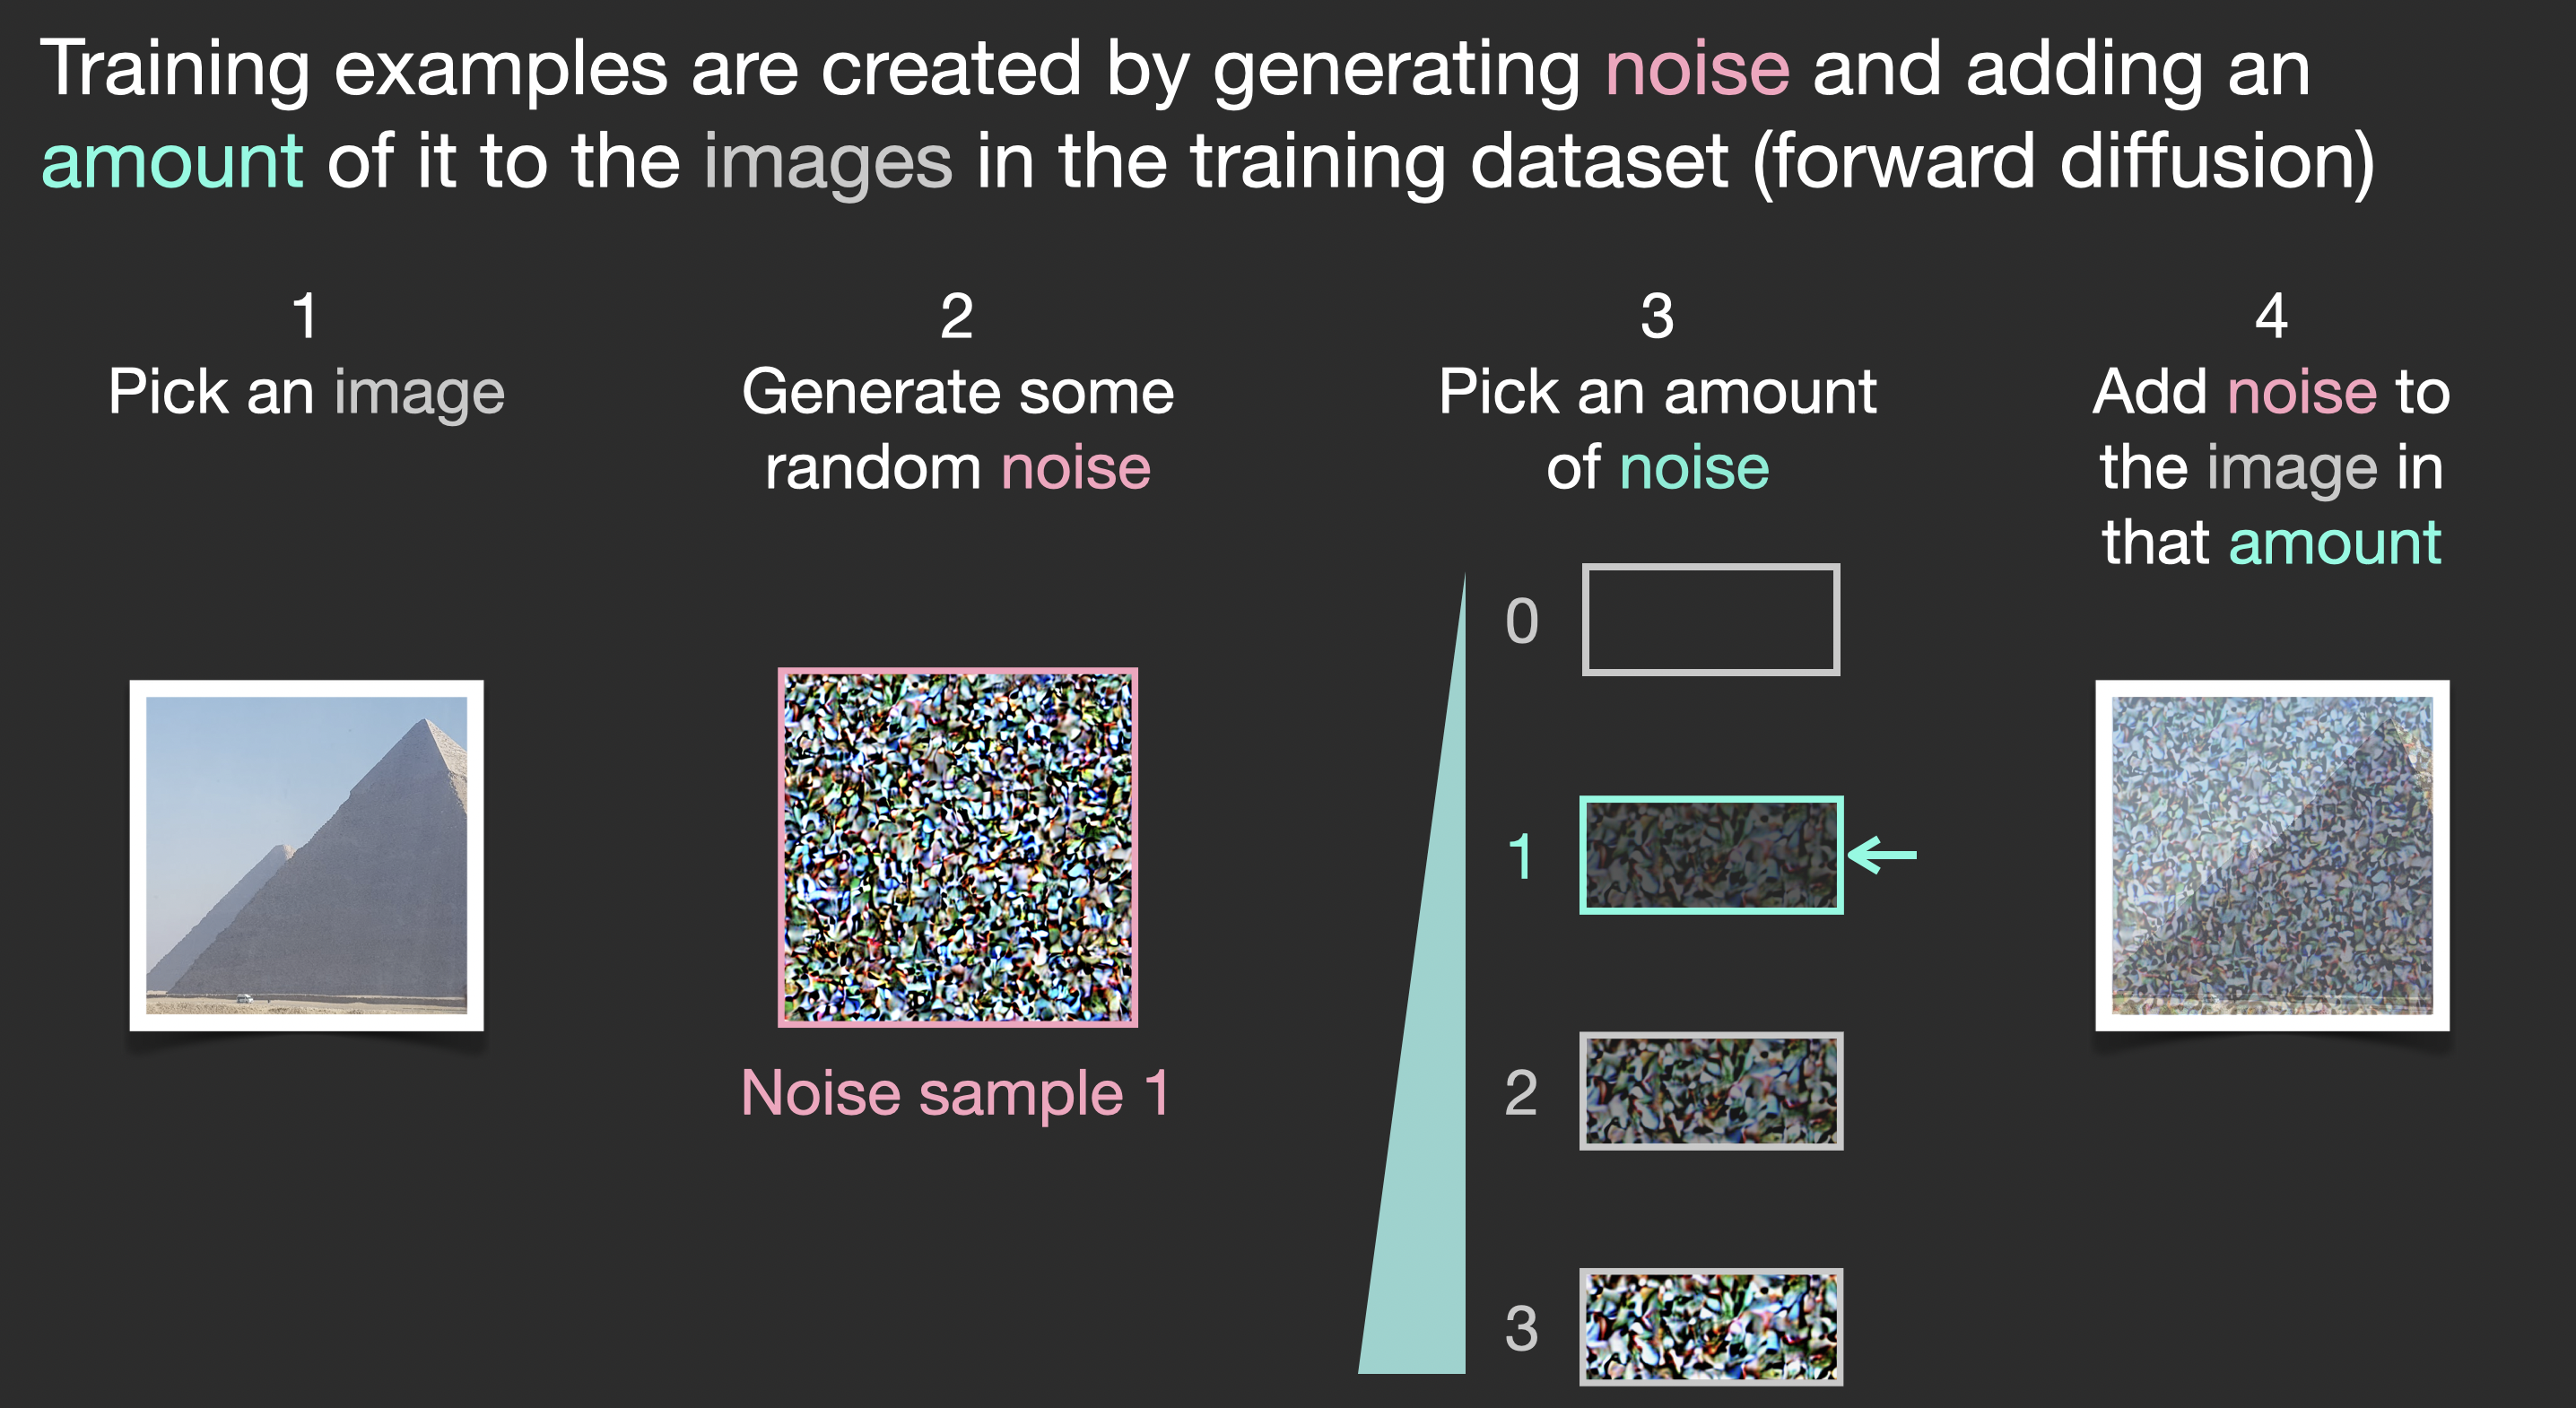
Questo può ora essere considerato un esempio di formazione. Possiamo usare questa stessa formula per creare molti esempi di addestramento per addestrare il componente centrale del nostro modello di generazione di immagini.
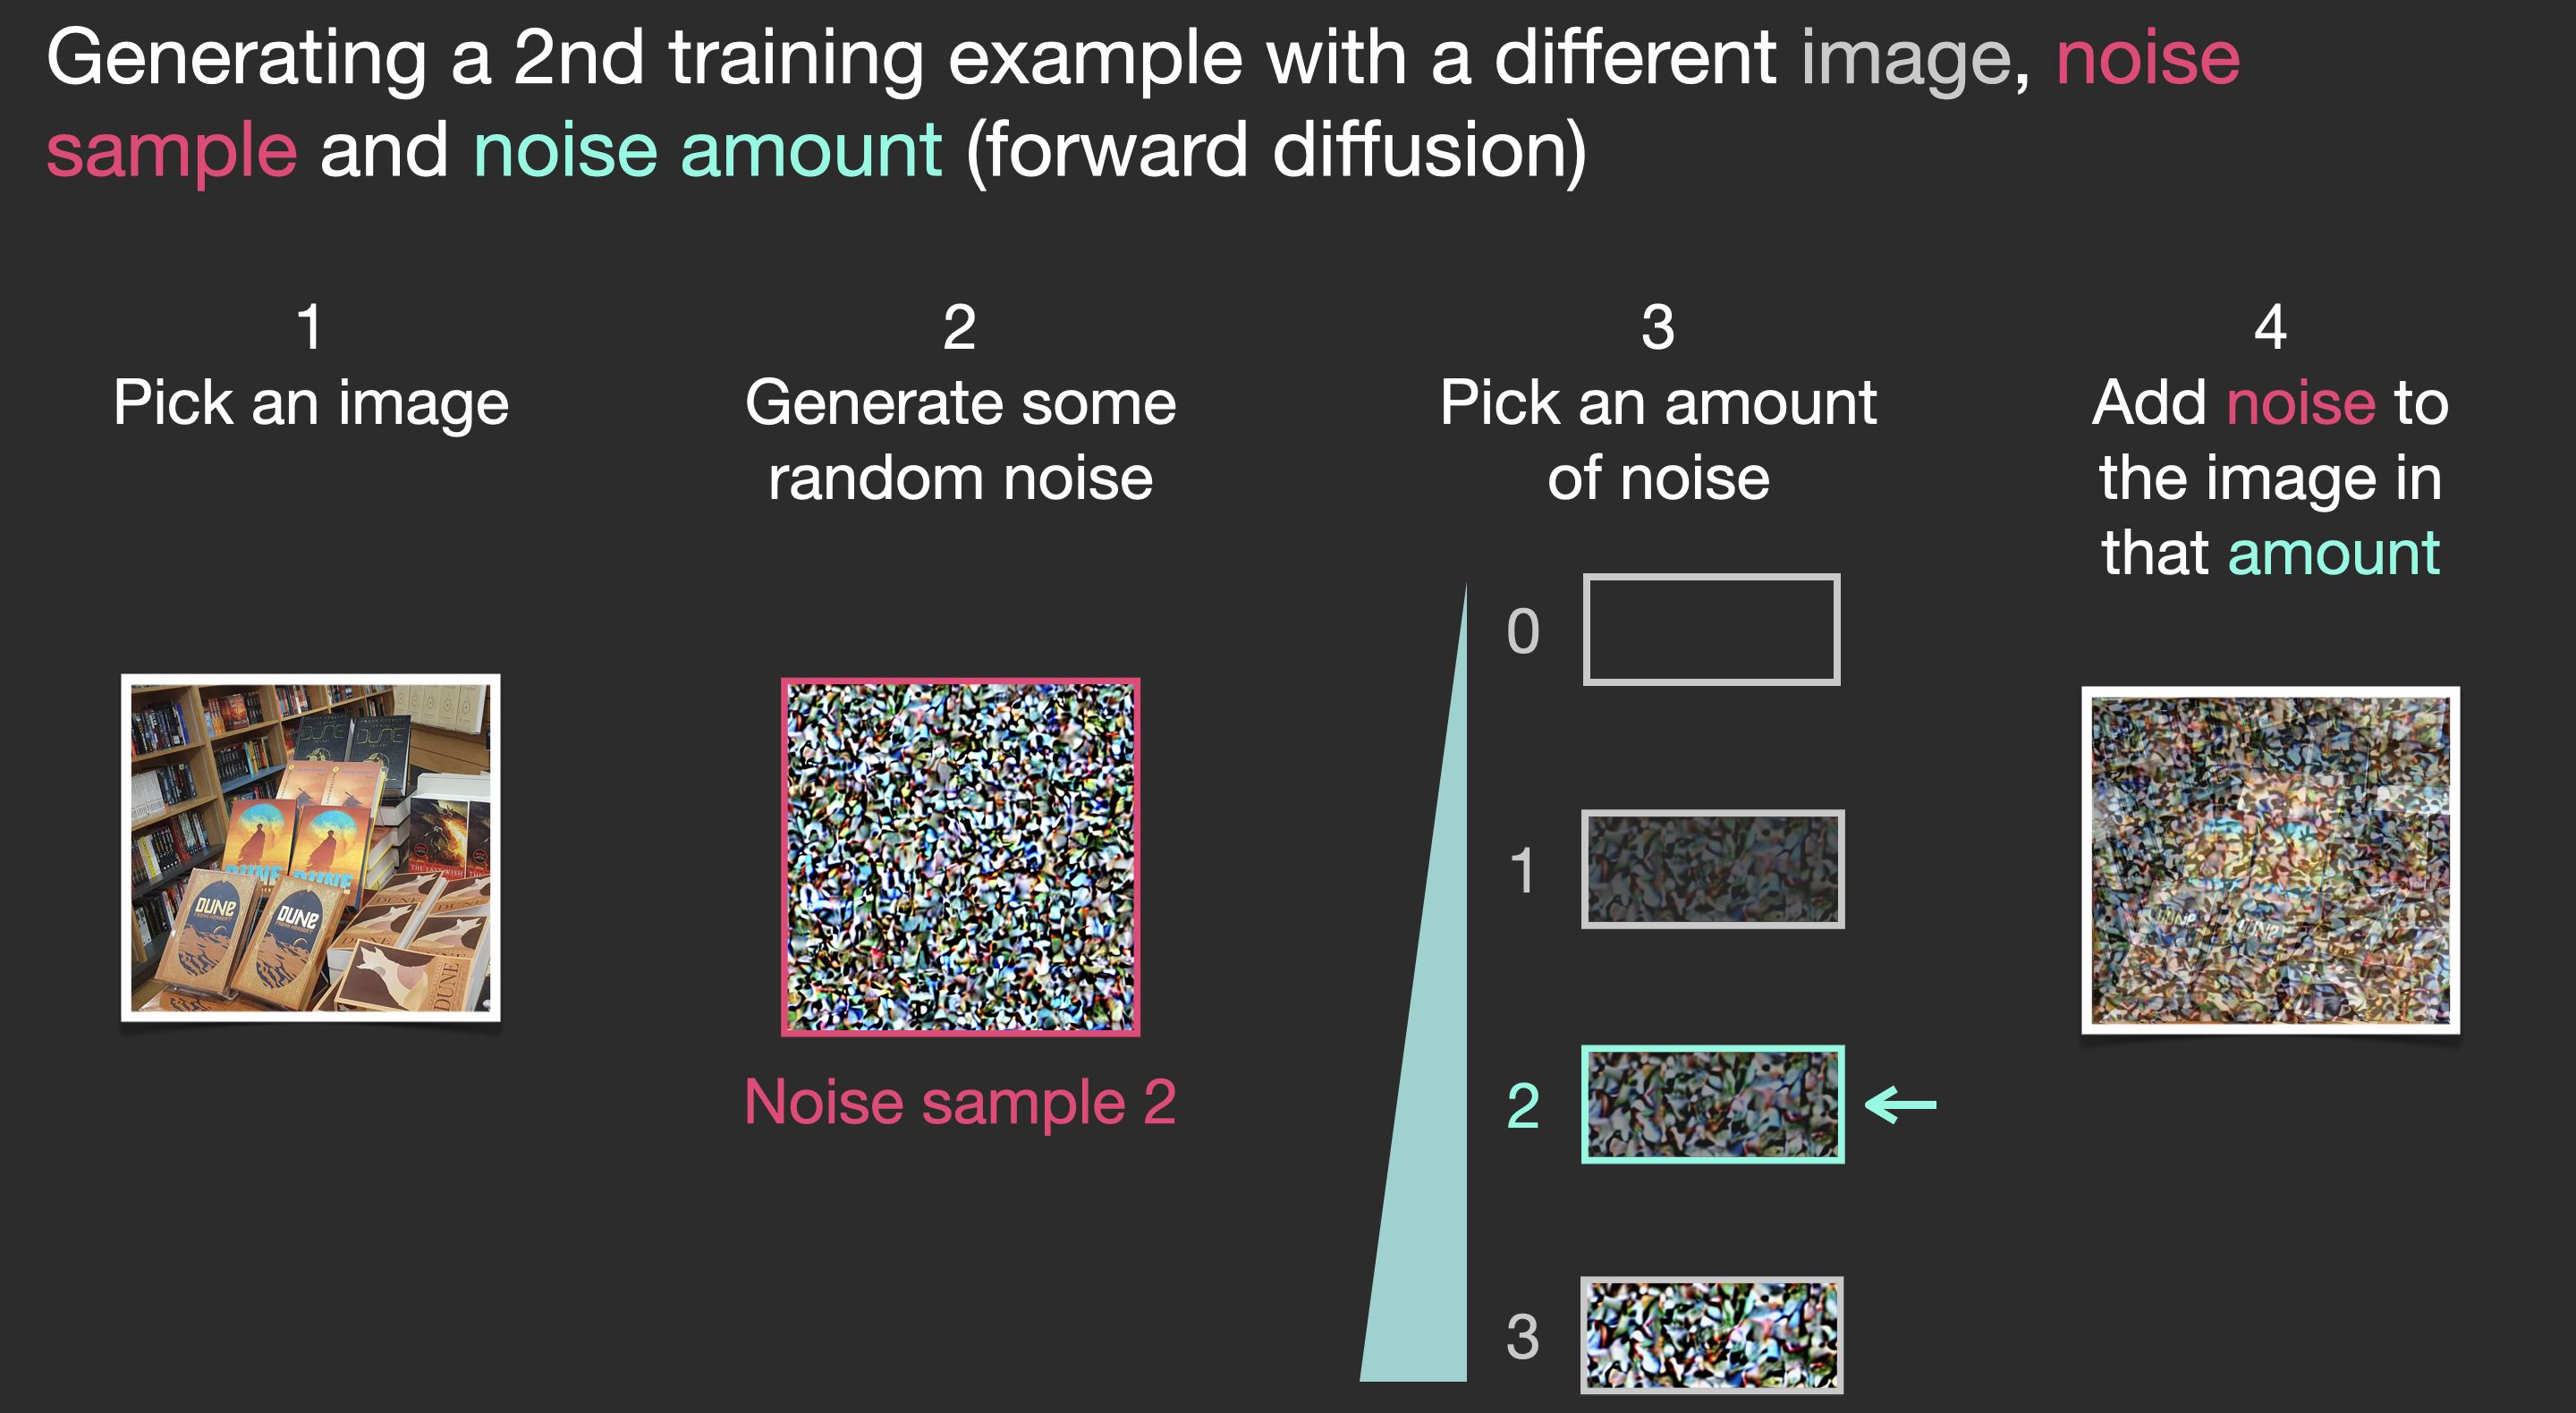
Mentre questo esempio mostra alcuni valori di quantità di rumore dall’immagine (quantità 0, nessun rumore) al rumore totale (quantità 4, rumore totale), possiamo facilmente controllare la quantità di rumore da aggiungere all’immagine, e quindi possiamo distribuirla su decine di passaggi, creando decine di esempi di addestramento per immagine per tutte le immagini in un set di dati di addestramento.
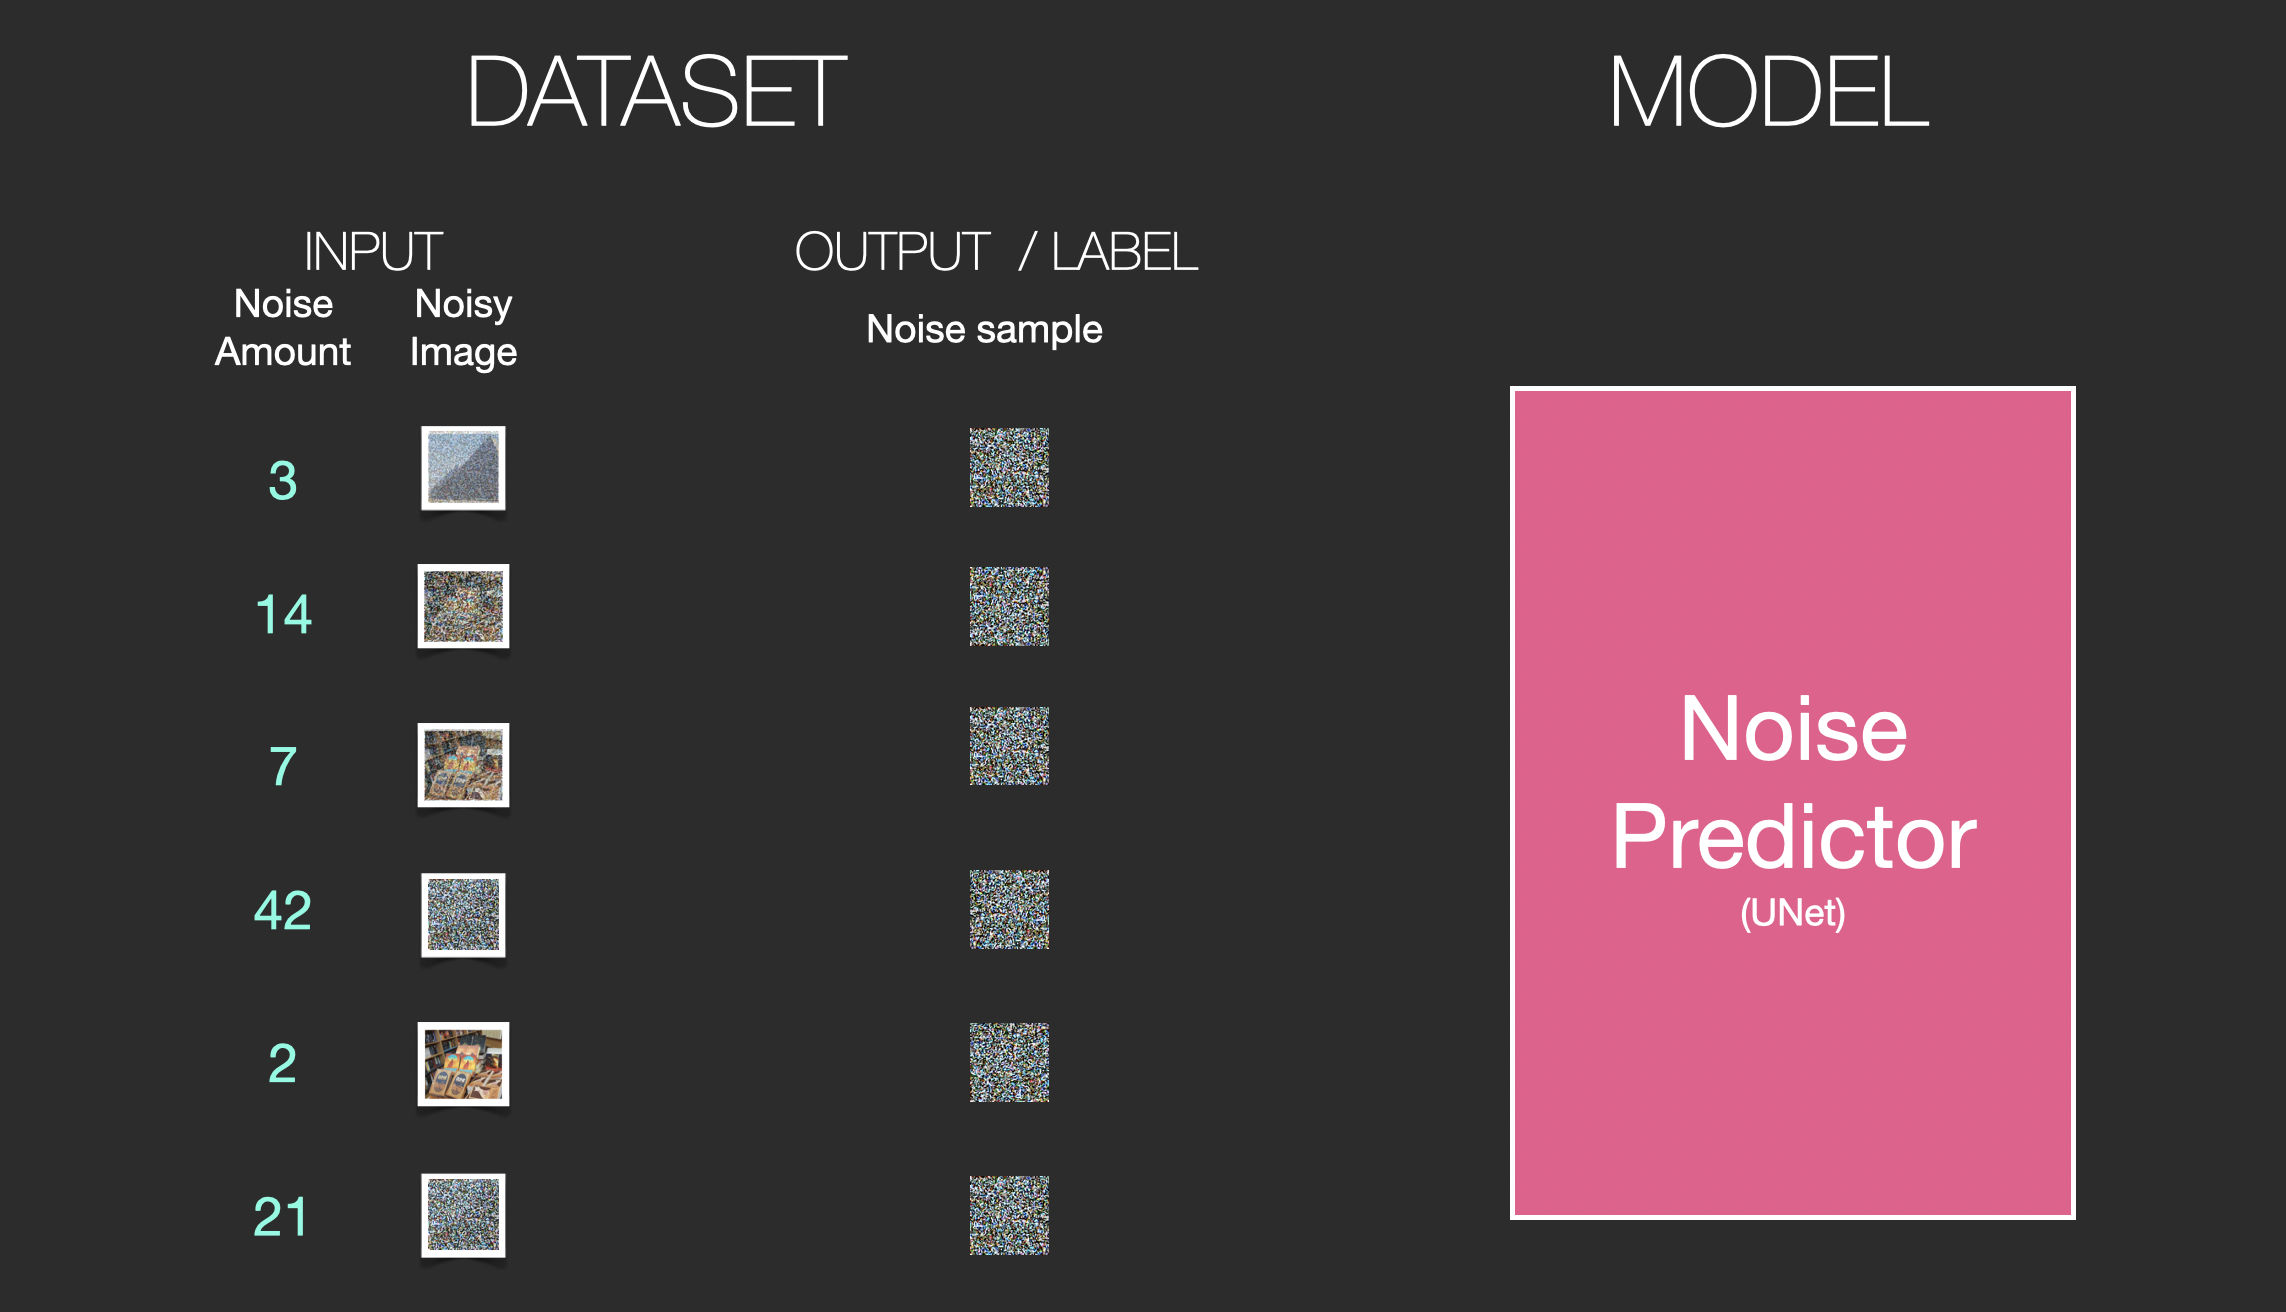
Con questo set di dati, possiamo addestrare il predittore di rumore e finire con un ottimo predittore di rumore che crea effettivamente immagini quando viene eseguito in una determinata configurazione. Una fase di formazione dovrebbe sembrare familiare se hai avuto un’esposizione al machine learning:
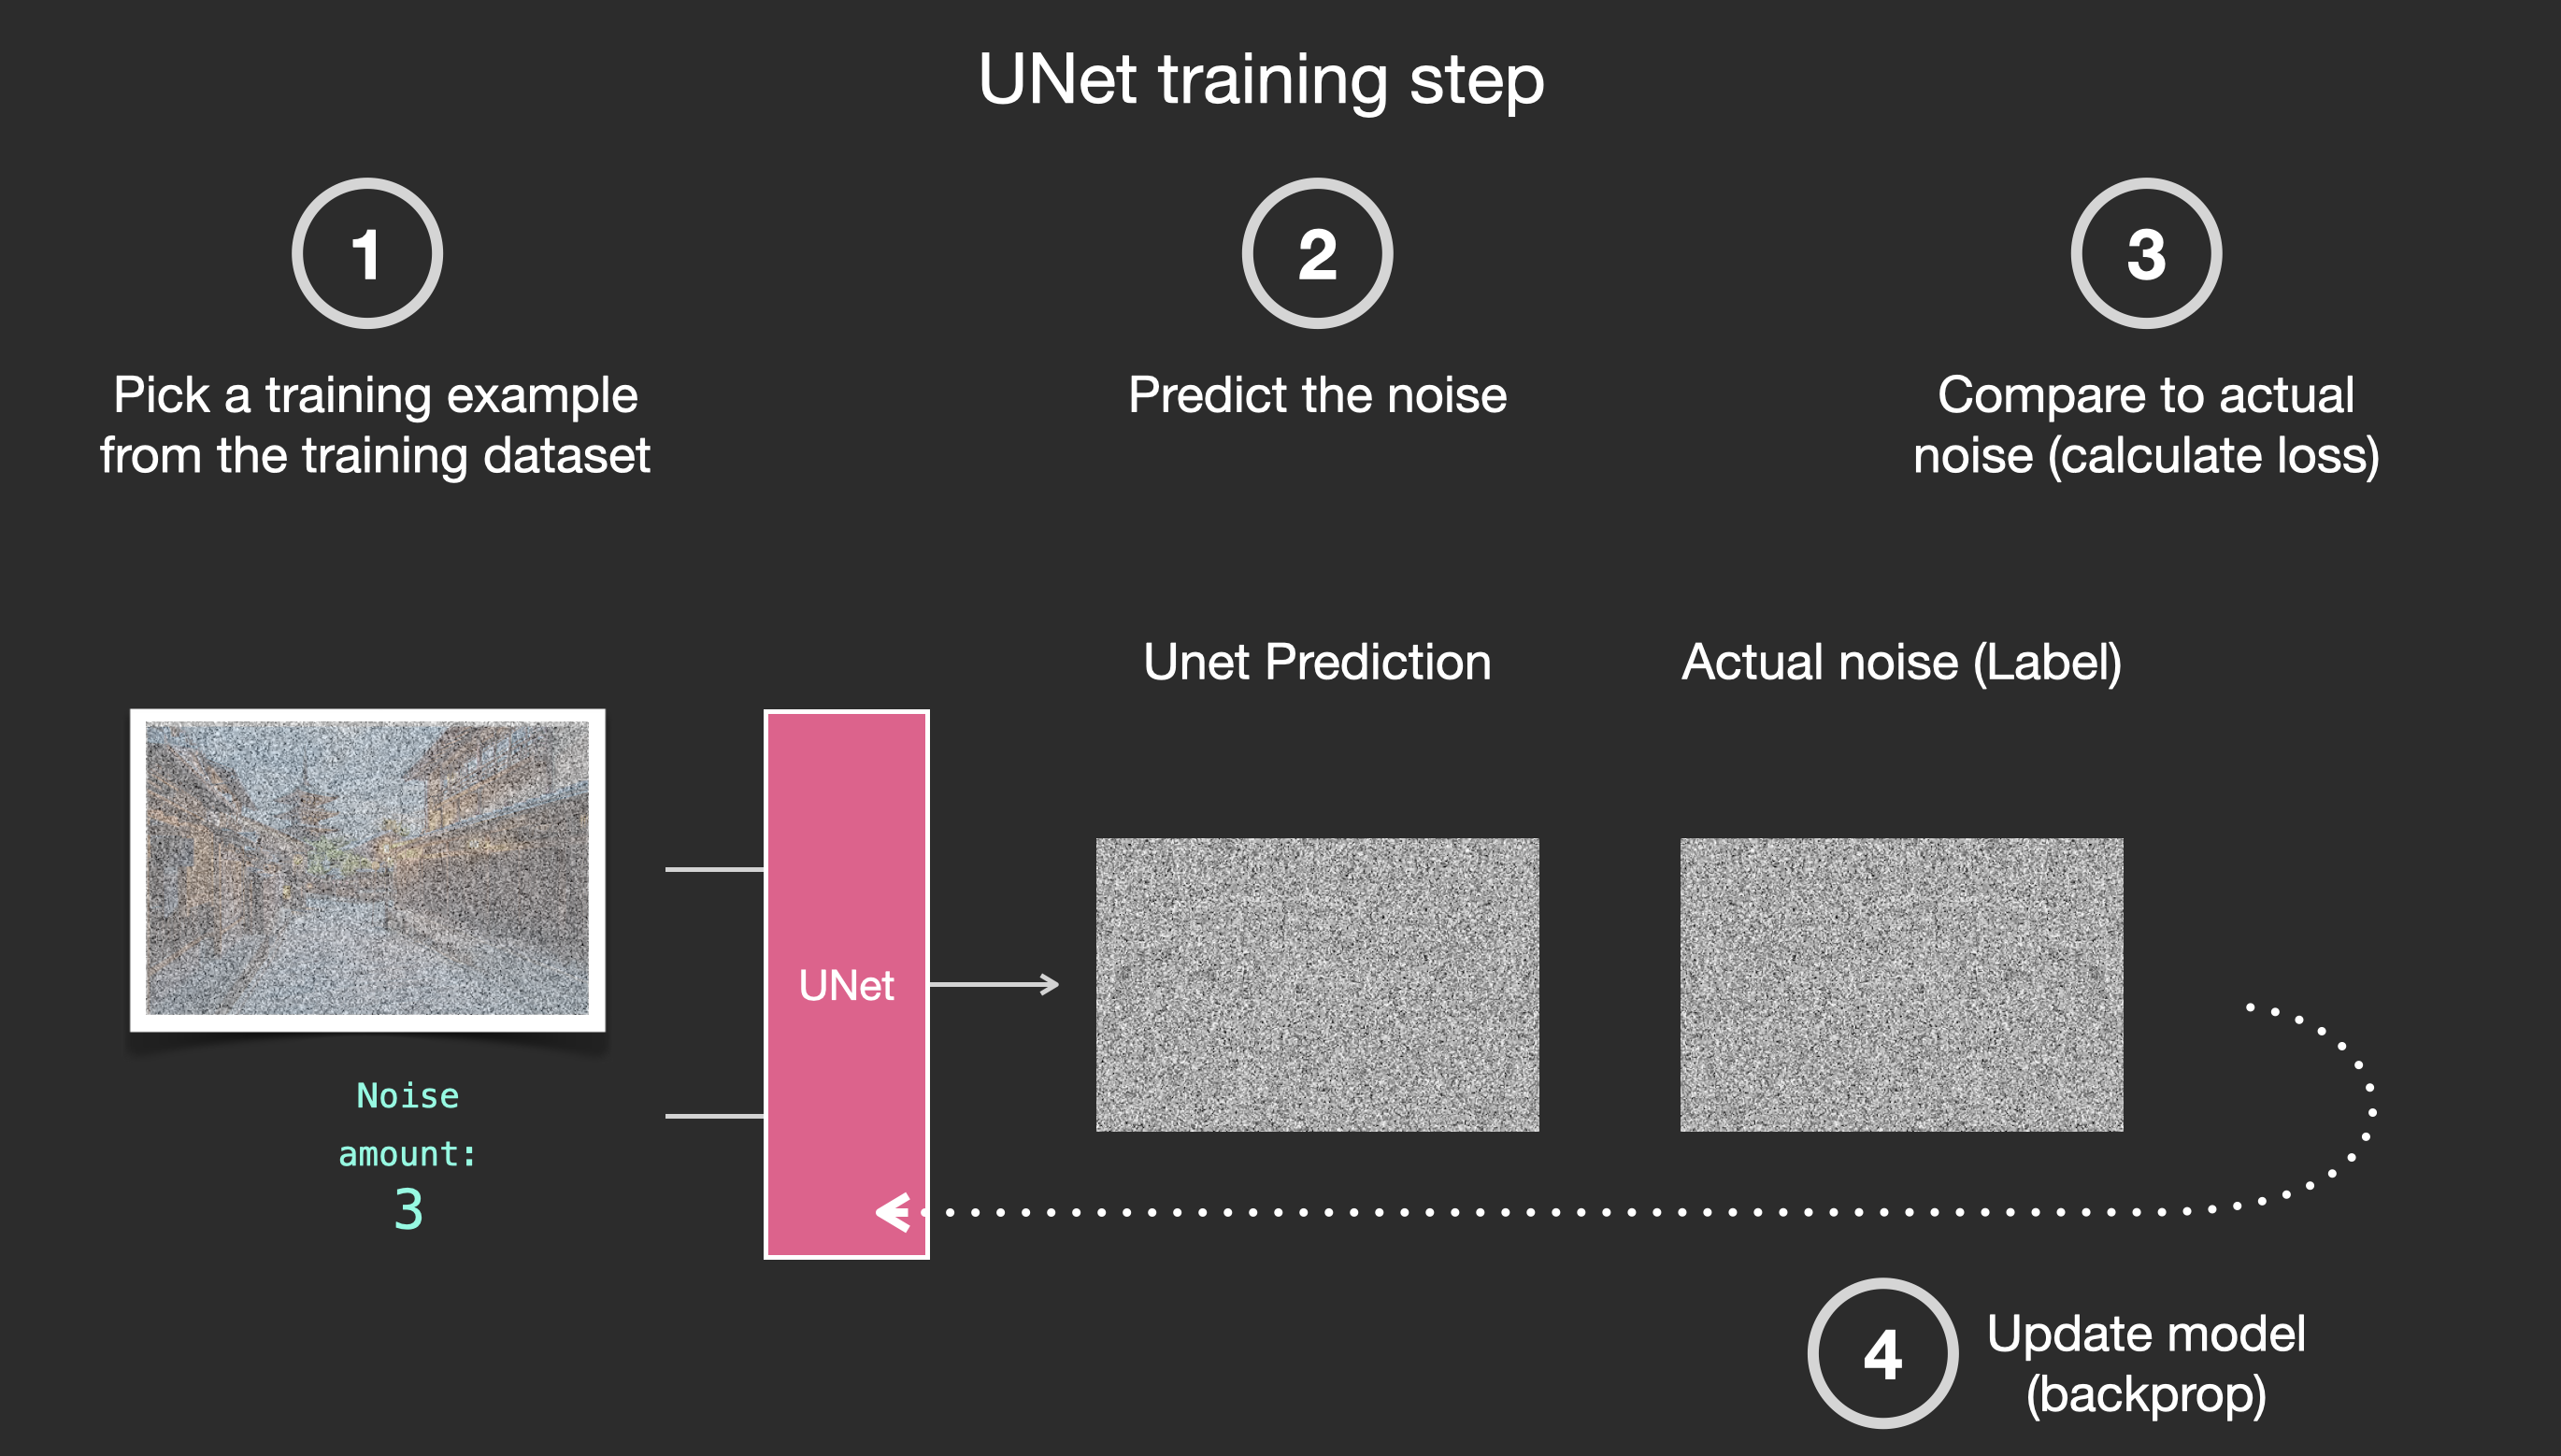
Vediamo ora come questo può generare immagini.
Dipingere le immagini rimuovendo il rumore
Il predittore di rumore addestrato può acquisire un’immagine rumorosa e il numero della fase di riduzione del rumore ed è in grado di prevedere una porzione di rumore.
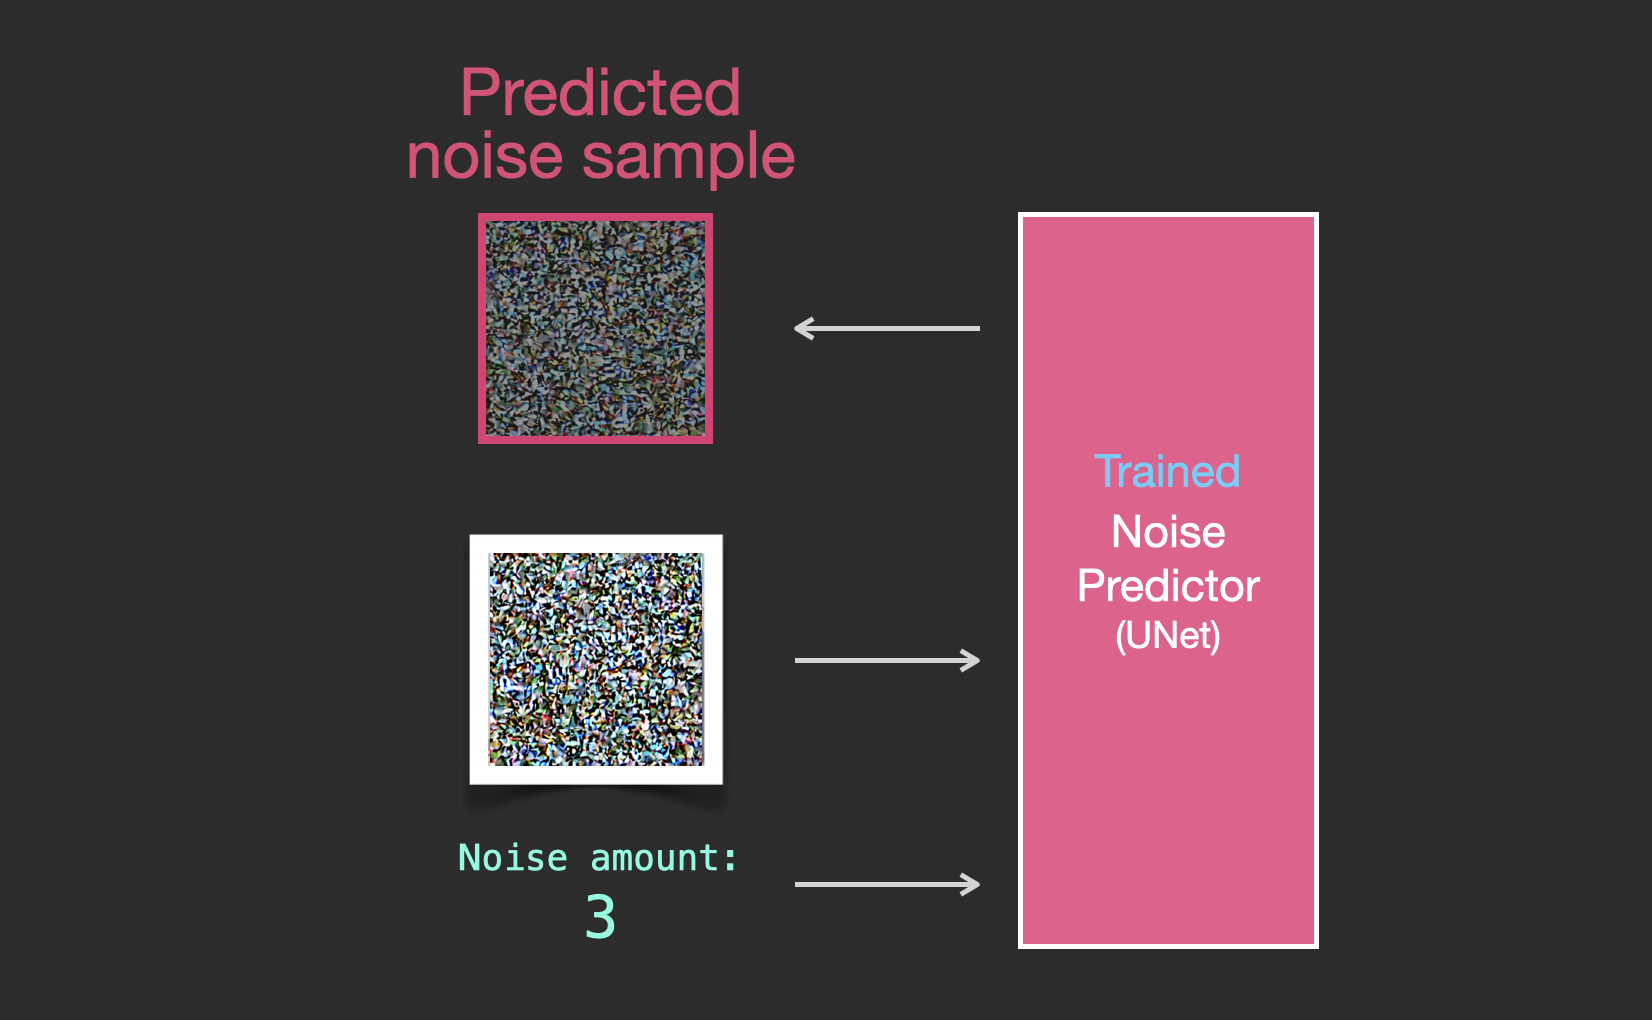
Il rumore campionato è previsto in modo che se lo sottraiamo dall’immagine, otteniamo un’immagine più vicina alle immagini su cui è stato addestrato il modello (non le immagini esatte stesse, ma la distribuzione – il mondo delle disposizioni dei pixel in cui il cielo è solitamente blu e al di sopra del suolo, le persone hanno due occhi, i gatti hanno un certo aspetto (orecchie appuntite e chiaramente indifferenti).
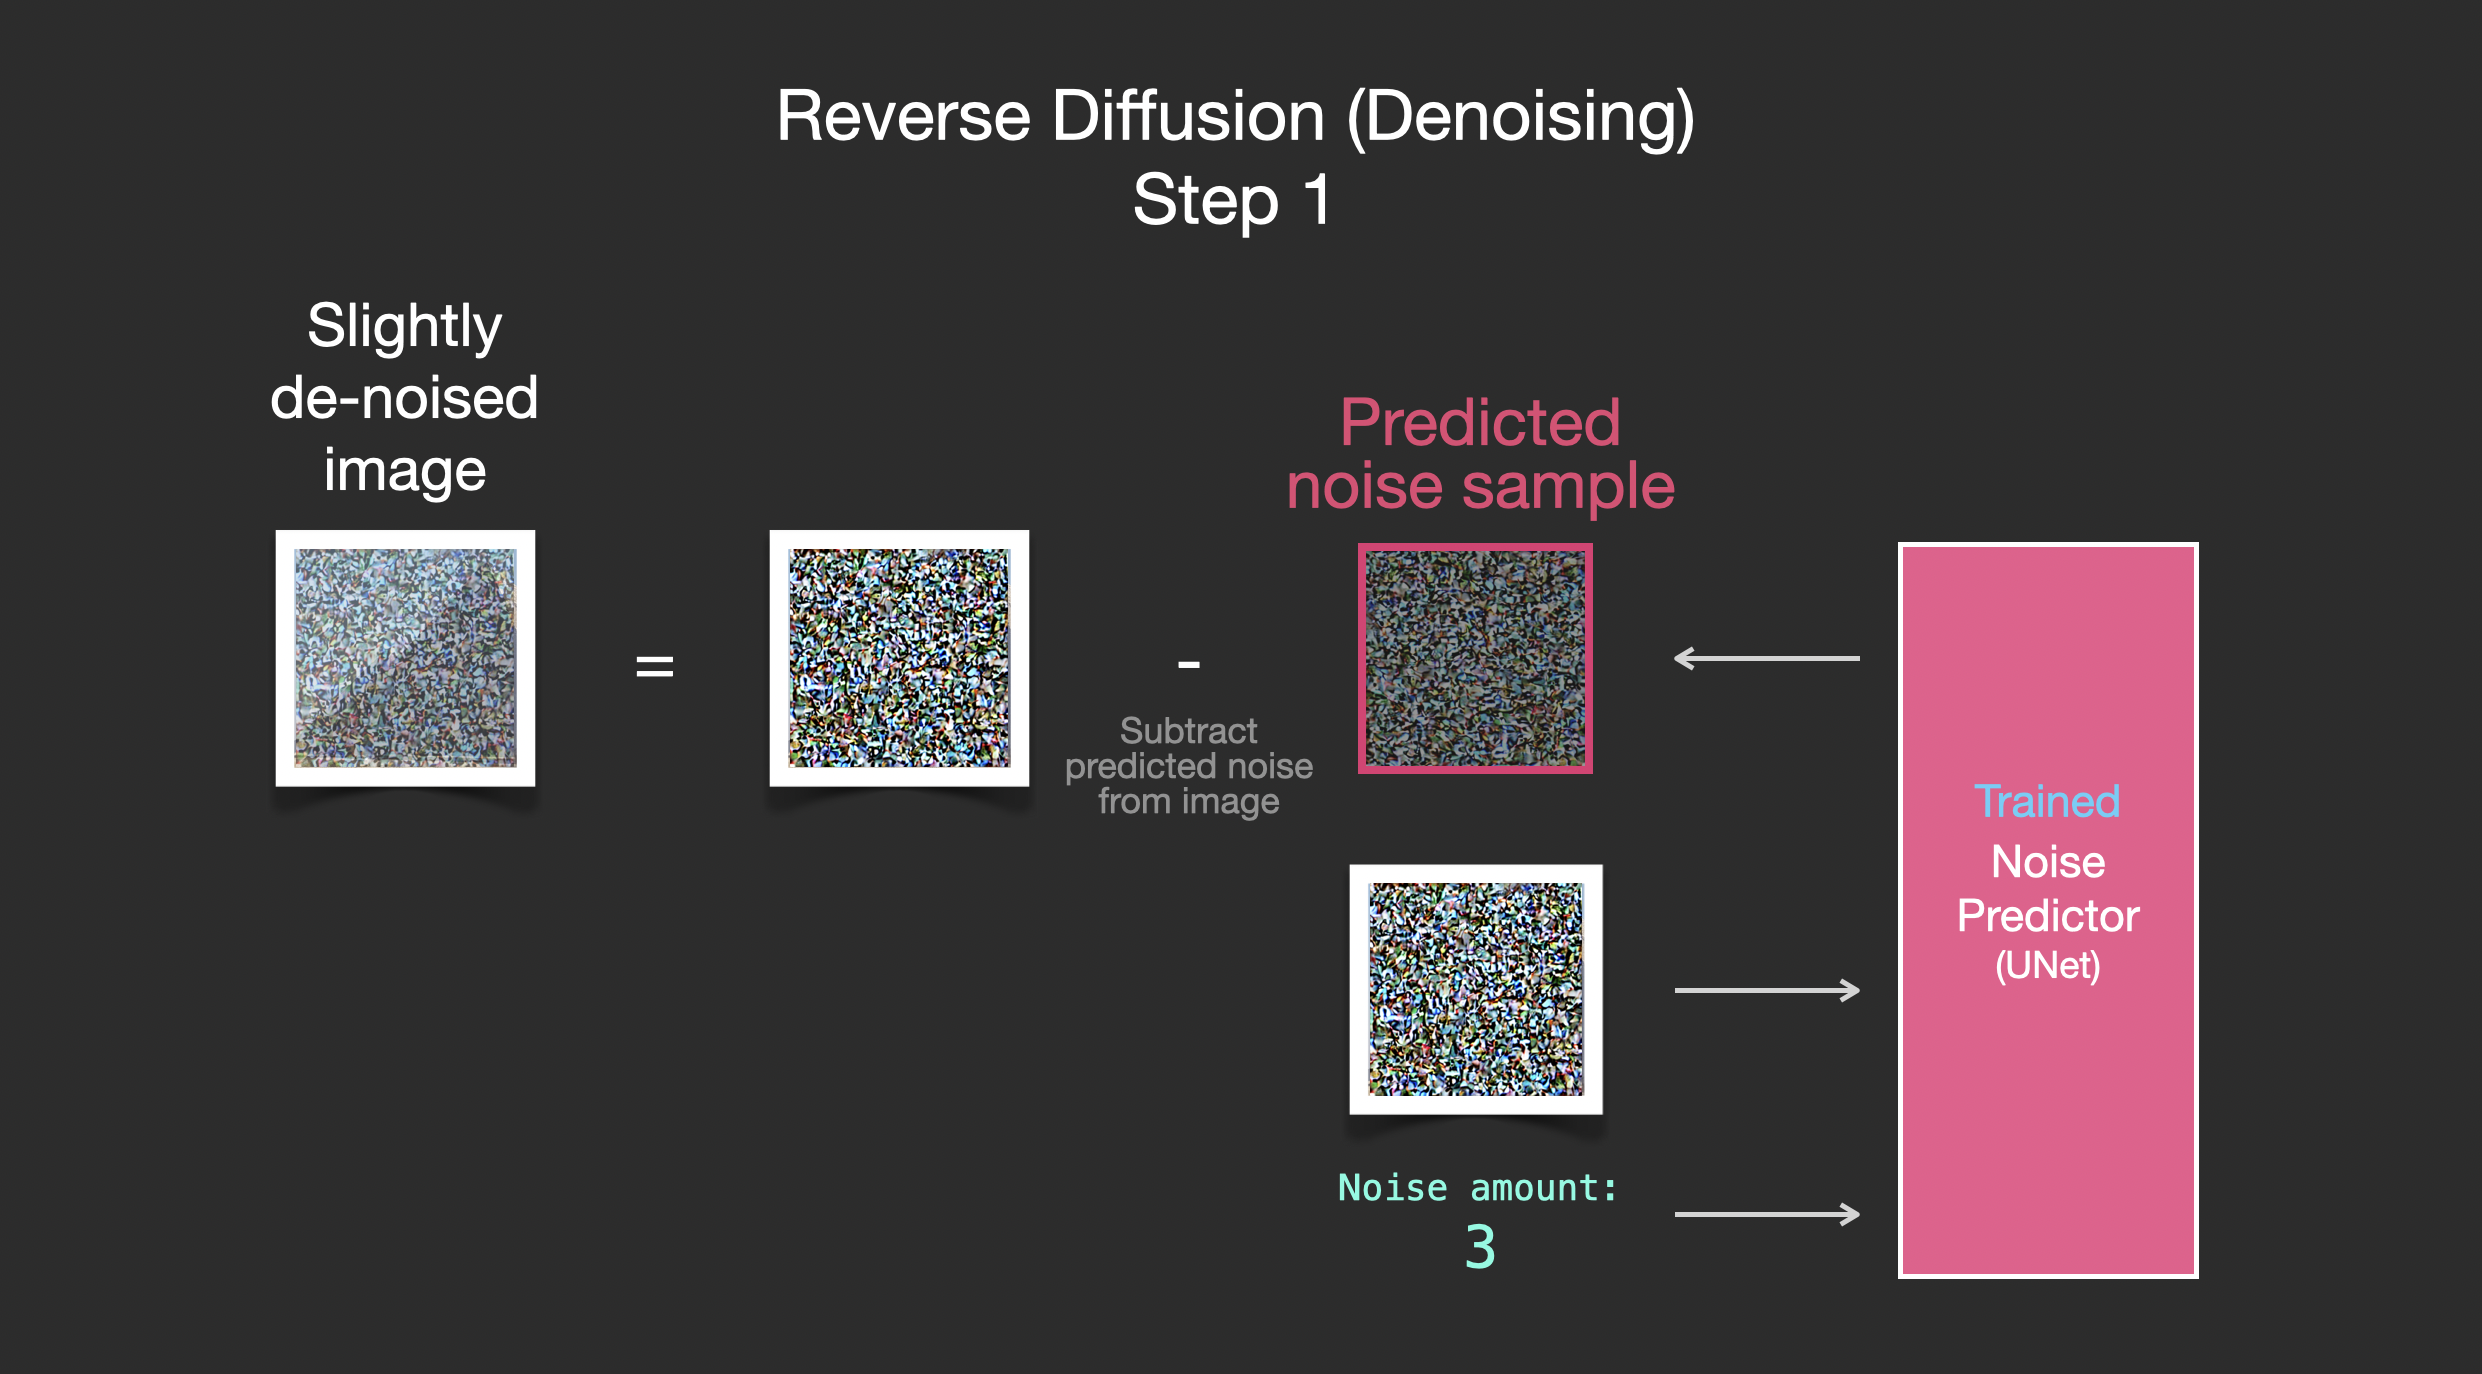
Se il set di dati di addestramento comprendeva immagini esteticamente gradevoli (ad esempio, LAION Aesthetics , su cui è stato addestrato Stable Diffusion), l’immagine risultante tenderebbe ad essere esteticamente gradevole. Se lo addestriamo su immagini di loghi, finiamo con un modello di generazione di loghi.
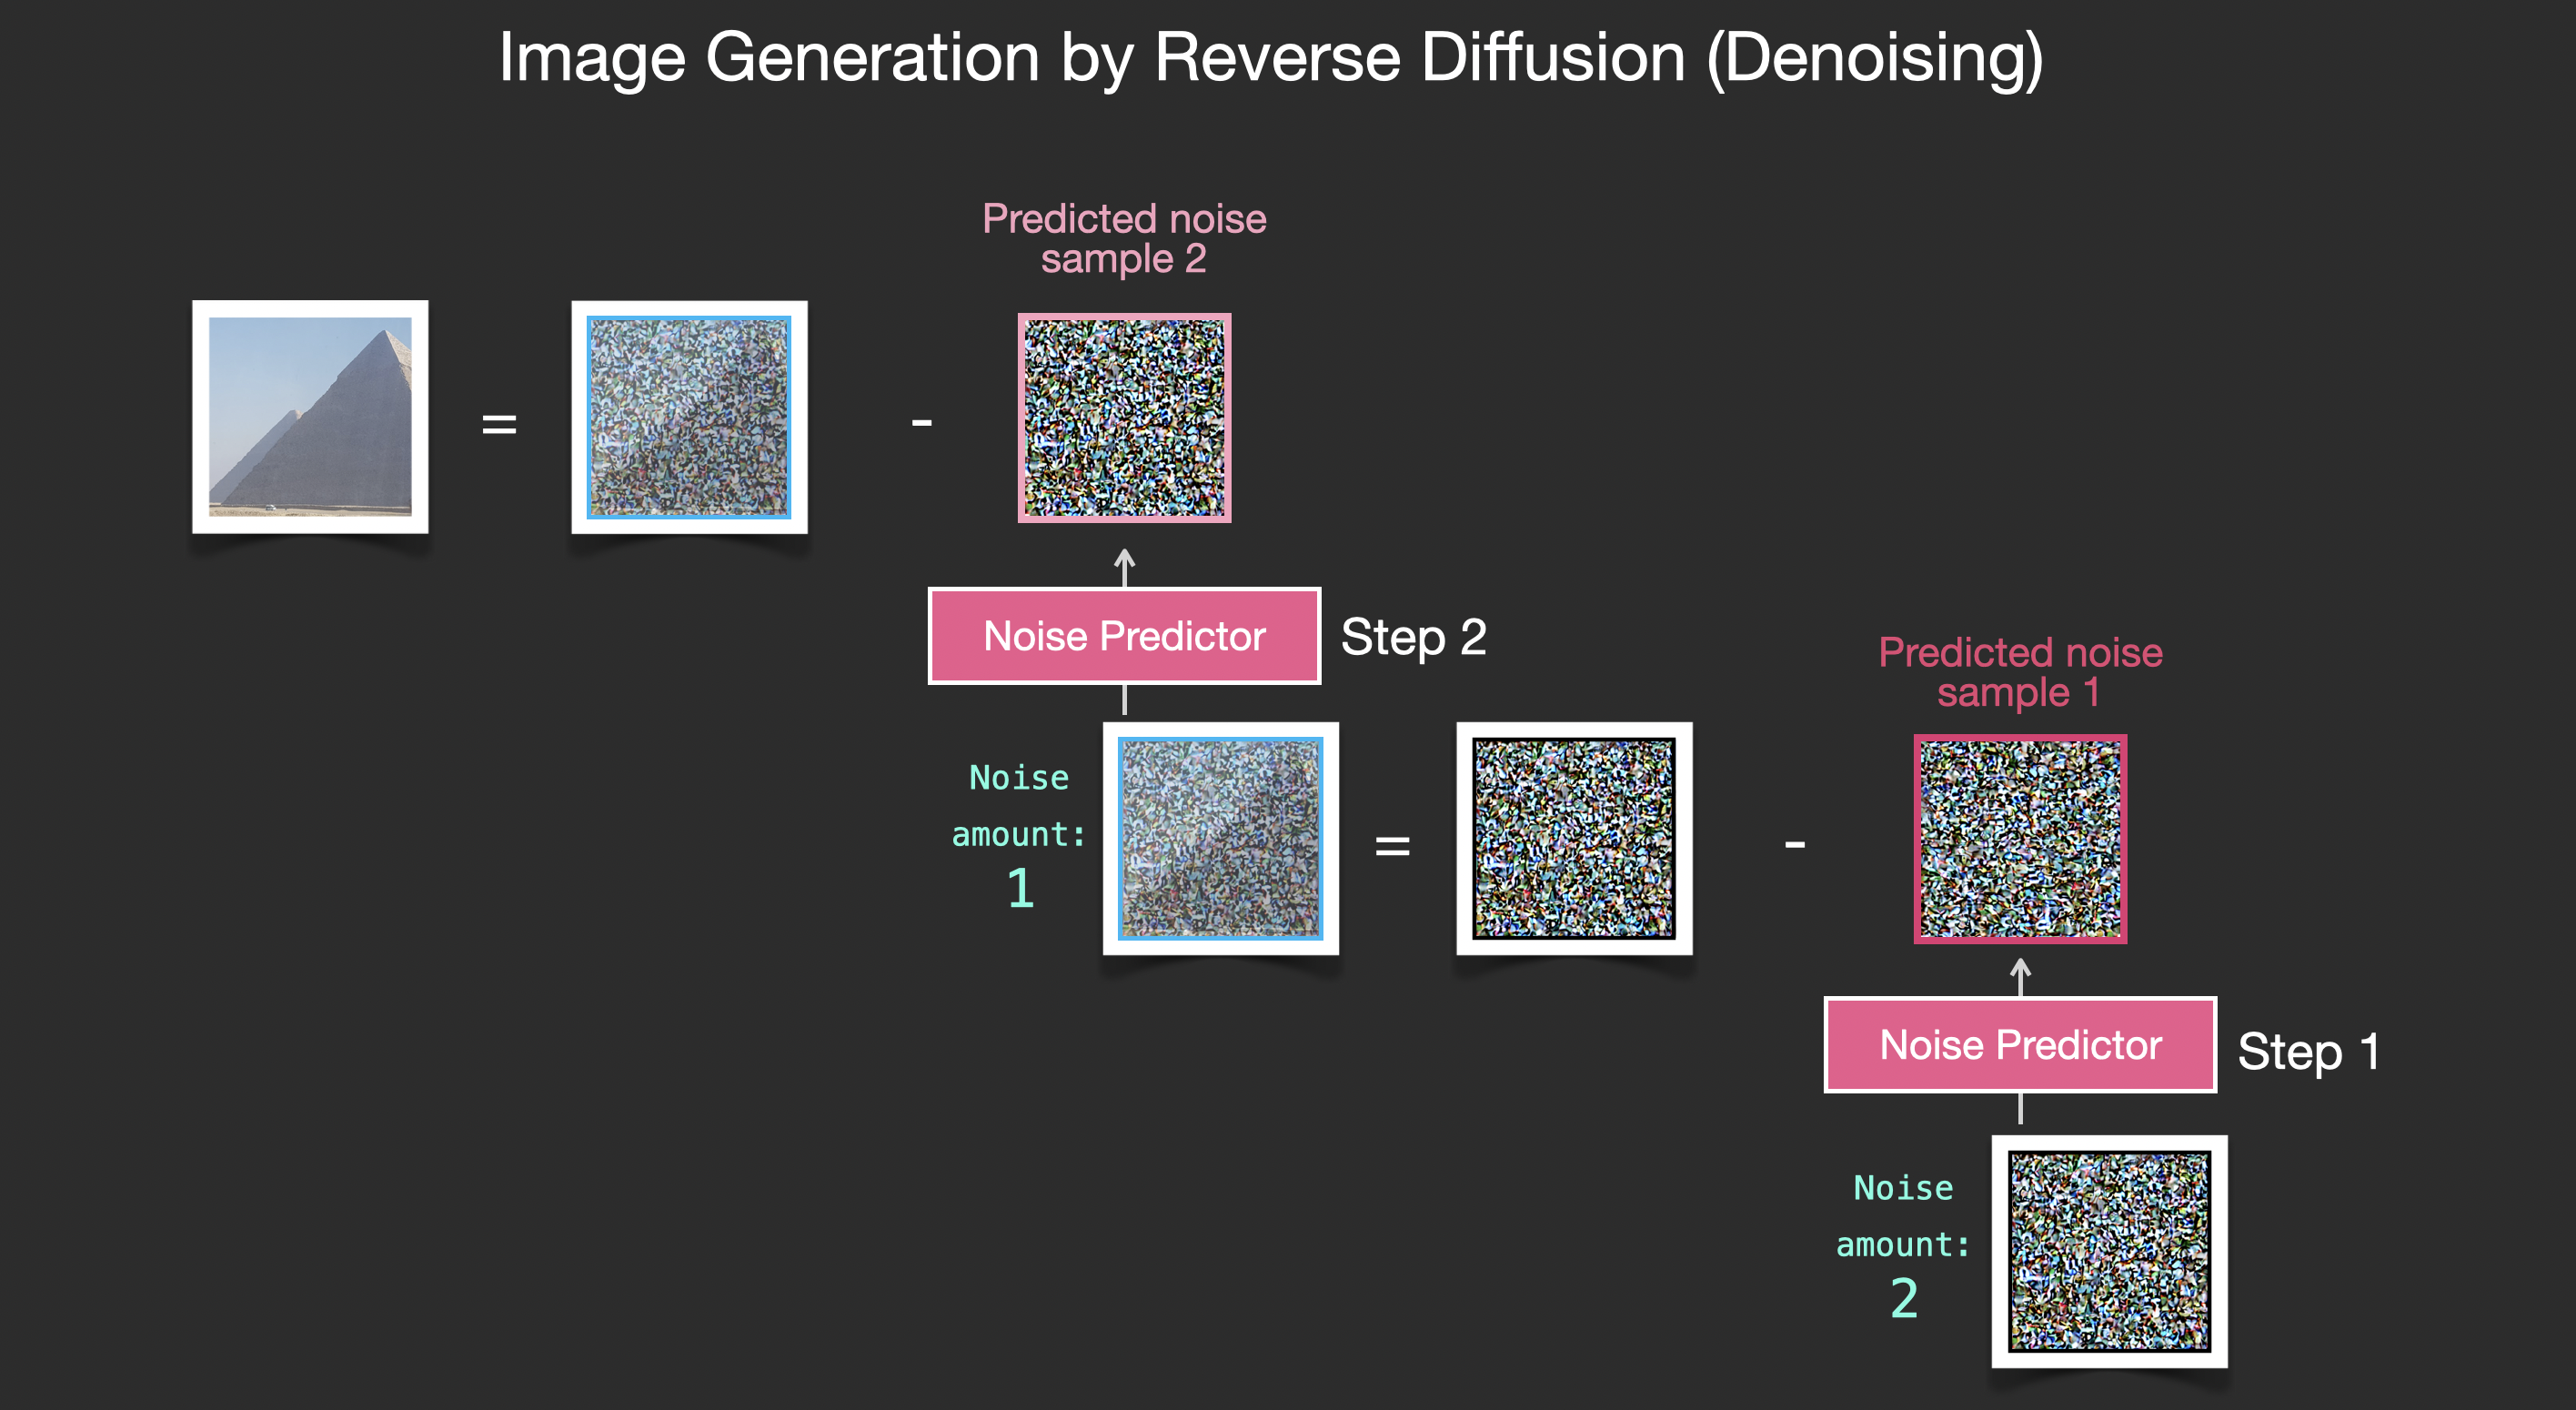
Questo conclude la descrizione della generazione di immagini mediante modelli di diffusione principalmente come descritto in Denoising Diffusion Probabilistic Models . Ora che hai questa intuizione della diffusione, conosci i componenti principali non solo di Stable Diffusion, ma anche di Dall-E 2 e Imagen di Google.
Si noti che il processo di diffusione che abbiamo descritto finora genera immagini senza utilizzare alcun dato di testo. Quindi, se distribuiamo questo modello, genererebbe immagini fantastiche, ma non avremmo modo di controllare se si tratta dell’immagine di una piramide o di un gatto o di qualsiasi altra cosa. Nelle prossime sezioni descriveremo come il testo viene incorporato nel processo per controllare quale tipo di immagine genera il modello.
Aumento della velocità: diffusione su dati compressi (latenti) anziché sull’immagine pixel
Per accelerare il processo di generazione dell’immagine, la carta Stable Diffusion esegue il processo di diffusione non sulle immagini pixel stesse, ma su una versione compressa dell’immagine. Il documento chiama questo “Departure to Latent Space”.
Questa compressione (e successivamente decompressione/pittura) viene eseguita tramite un codificatore automatico. L’autocodificatore comprime l’immagine nello spazio latente utilizzando il suo codificatore, quindi la ricostruisce utilizzando solo le informazioni compresse utilizzando il decodificatore.
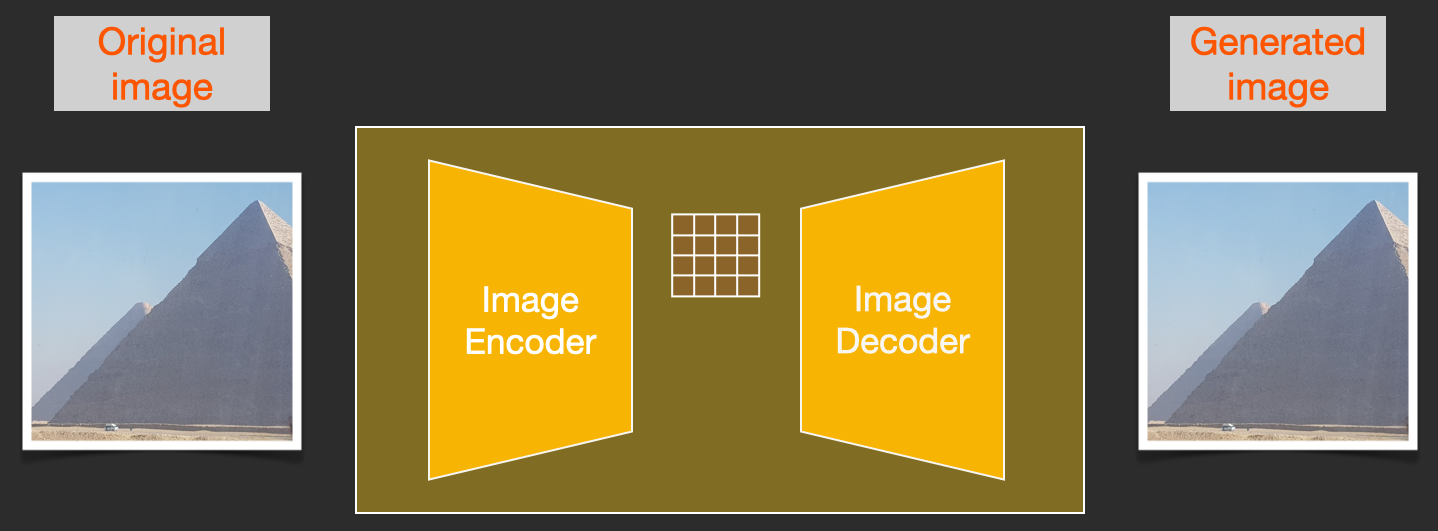
Ora il processo di diffusione in avanti viene eseguito sui latenti compressi. Le fette di rumore sono di rumore applicato a quelle latenti, non all’immagine pixel. E così il predittore del rumore è effettivamente addestrato a prevedere il rumore nella rappresentazione compressa (lo spazio latente).
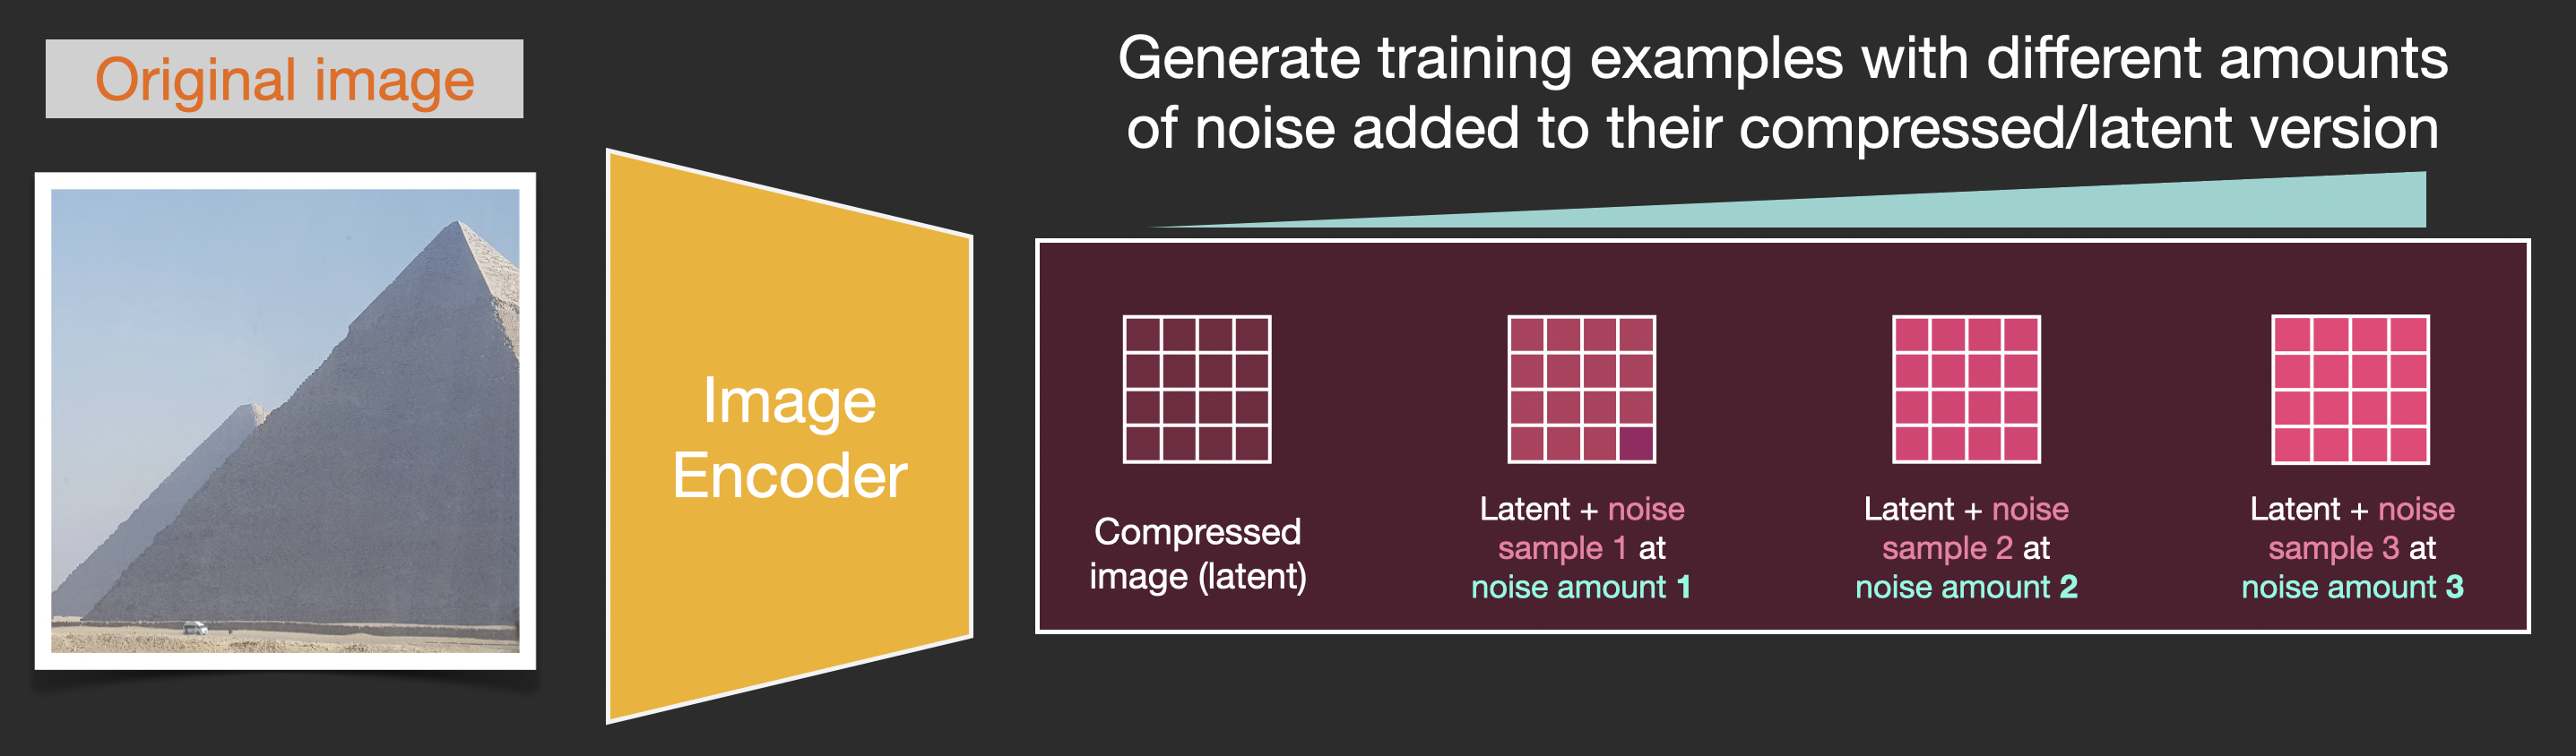
Il processo forward (utilizzando il codificatore dell’autoencoder) è il modo in cui generiamo i dati per addestrare il predittore del rumore. Una volta addestrato, possiamo generare immagini eseguendo il processo inverso (utilizzando il decodificatore dell’autoencoder).
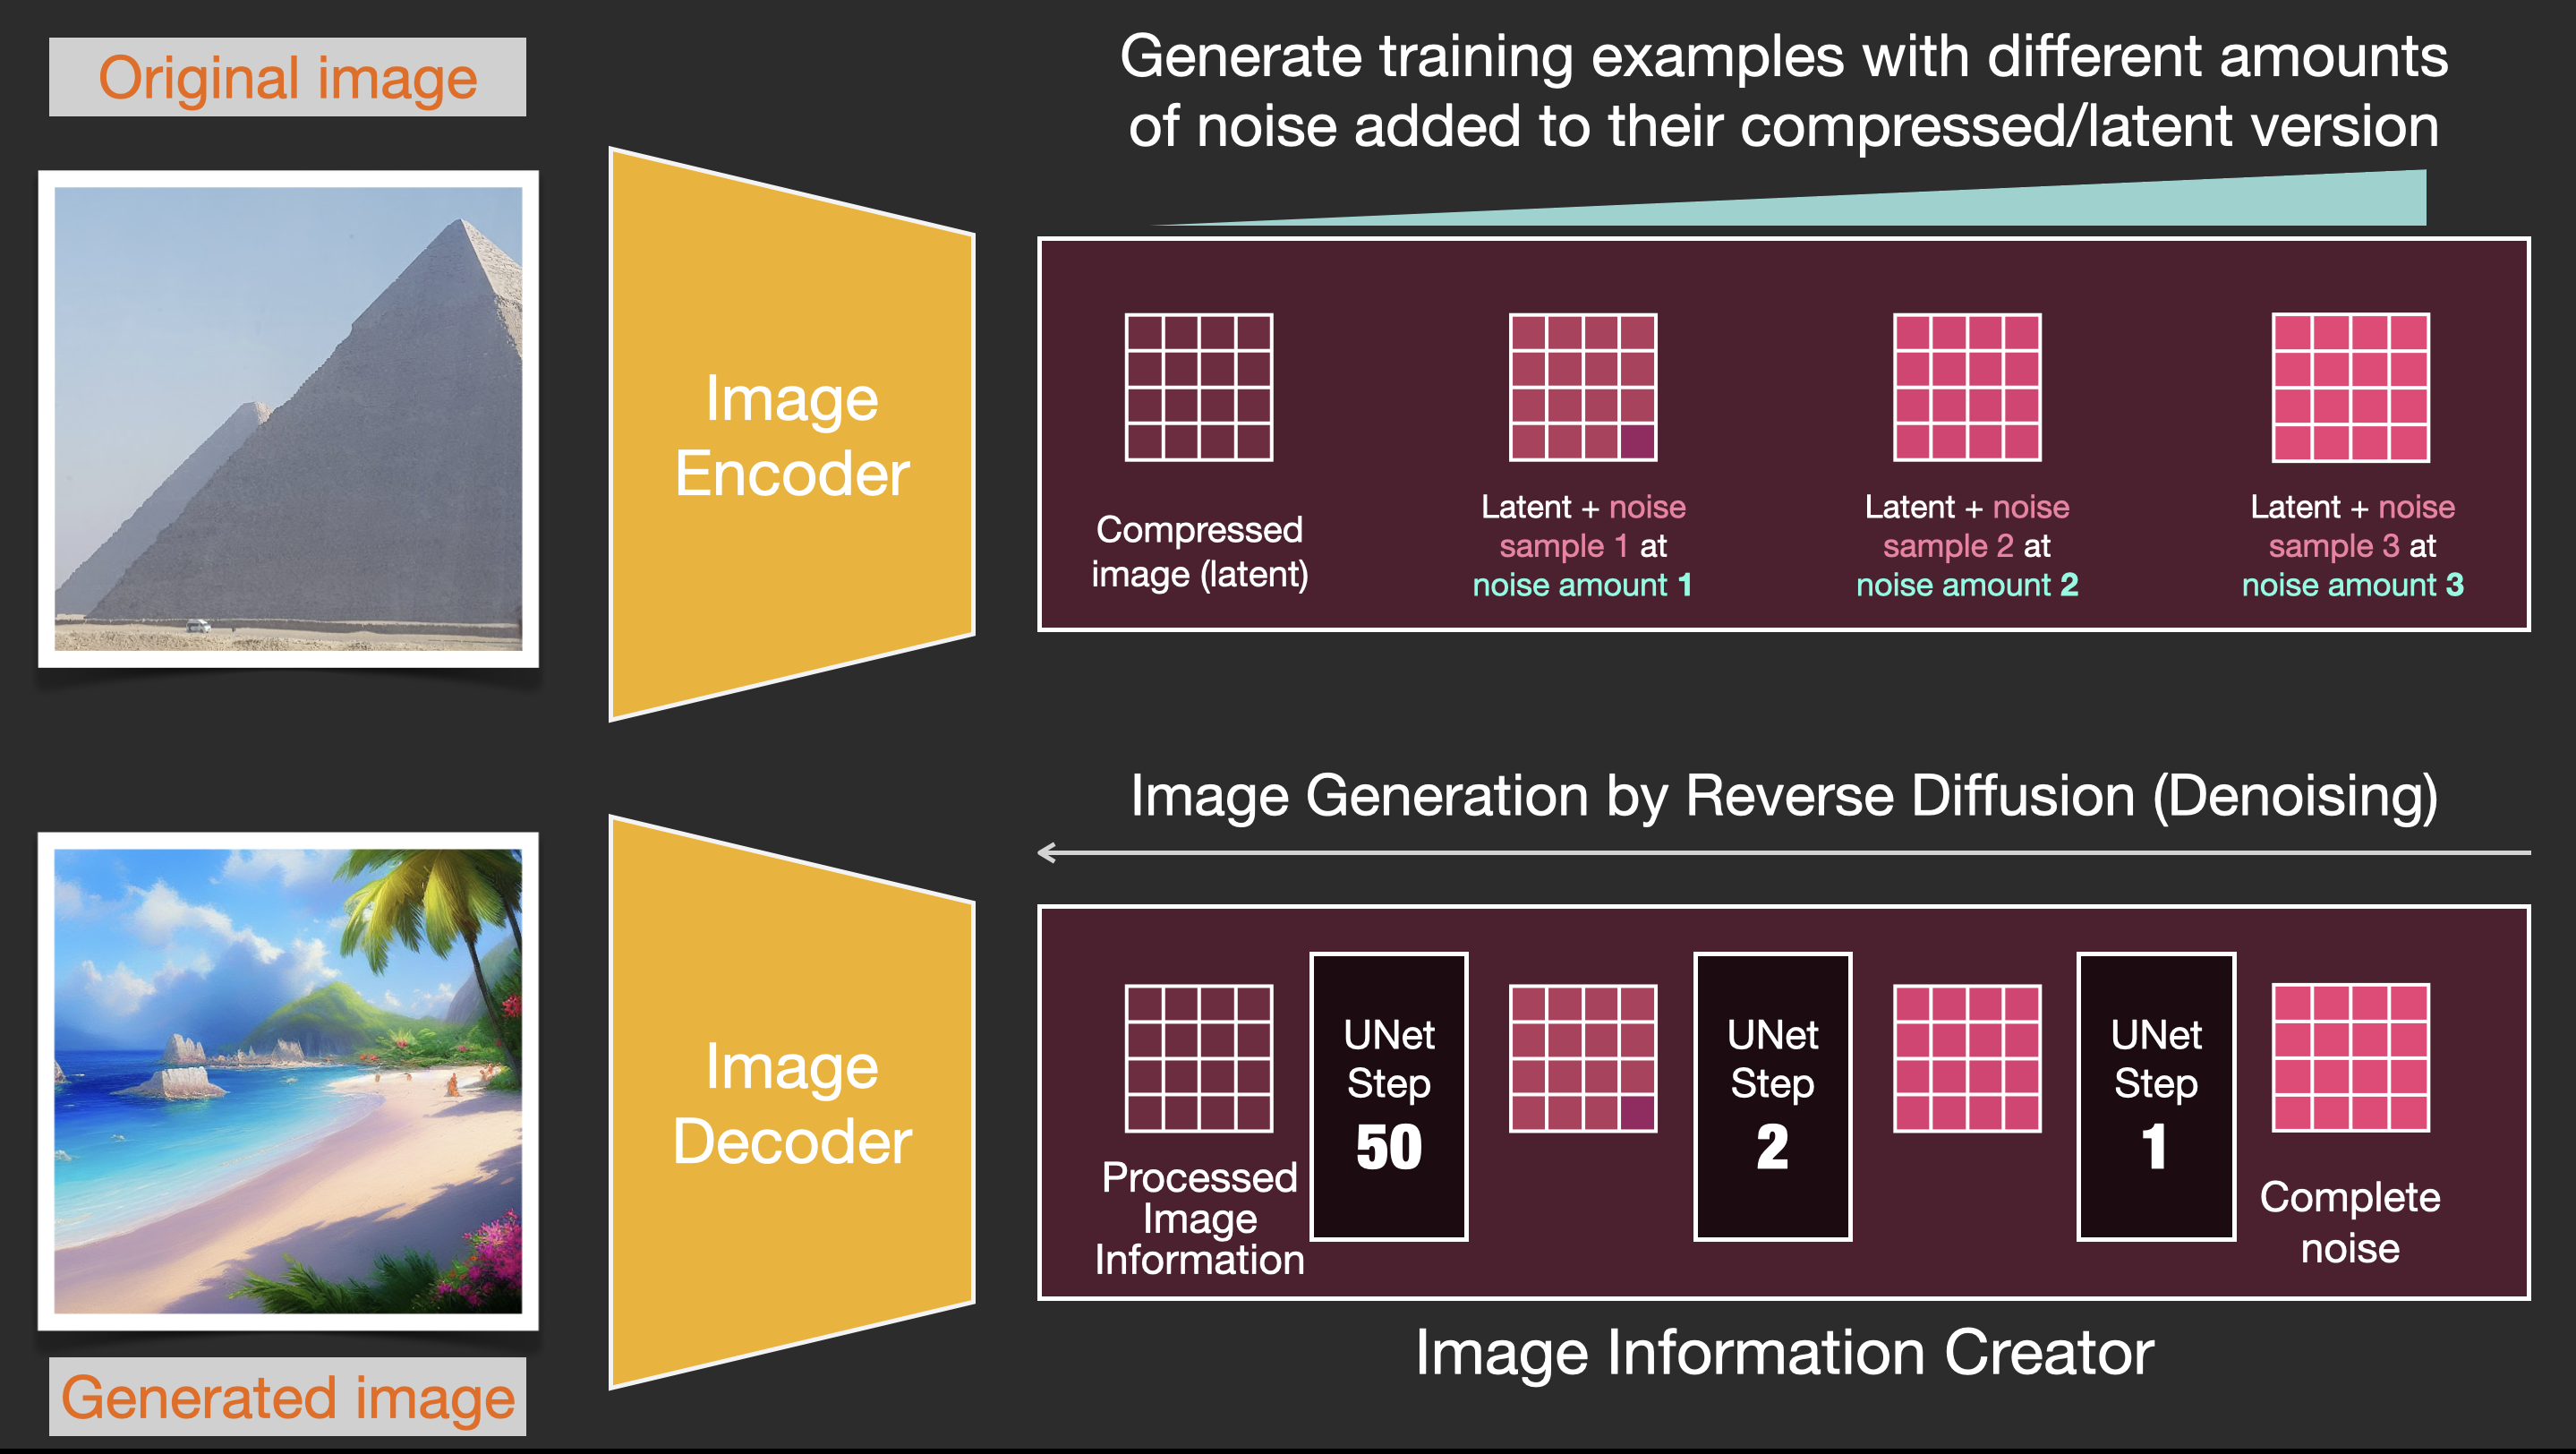
Questi due flussi sono quelli mostrati nella Figura 3 del documento LDM/Stable Diffusion:
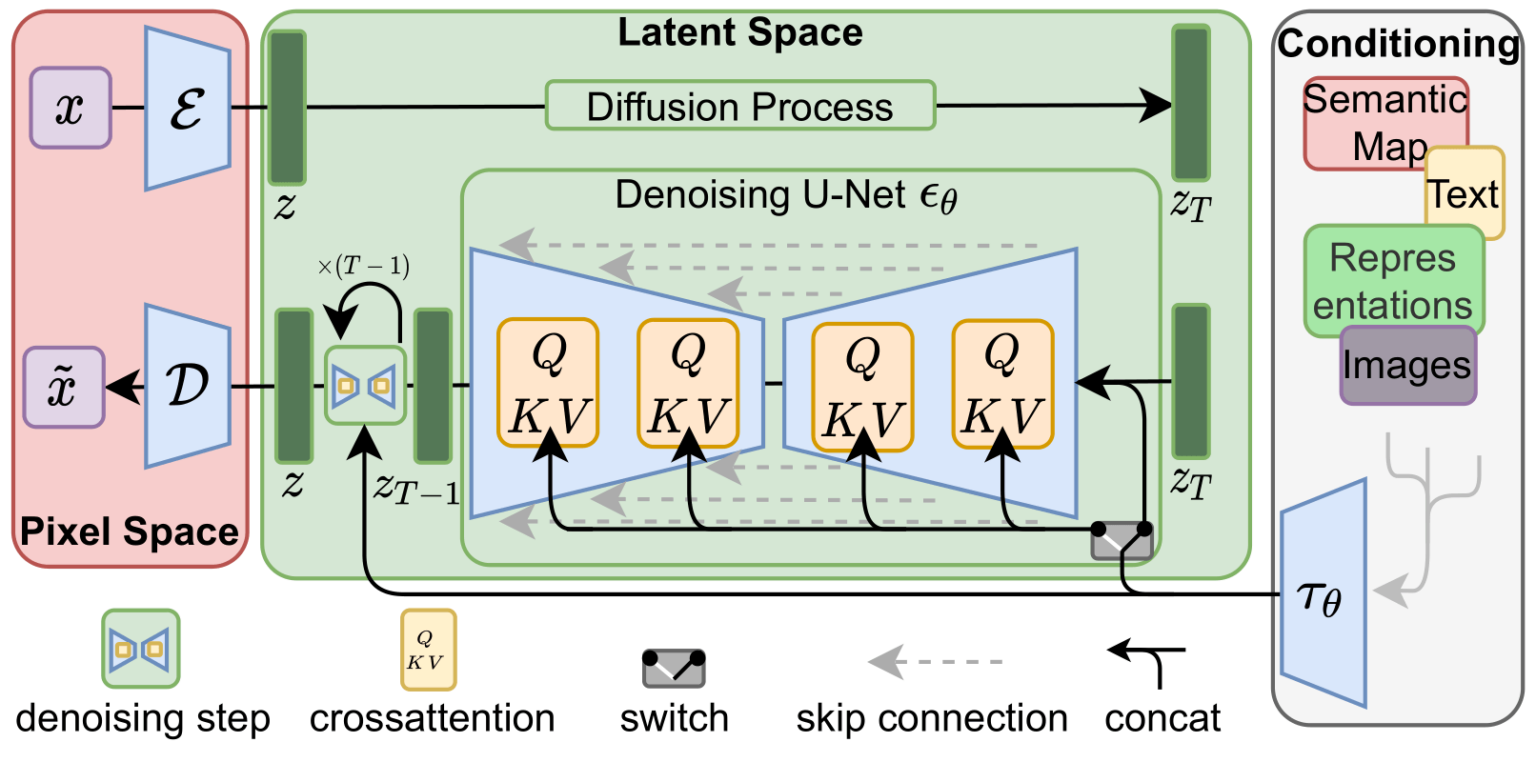
Questa figura mostra inoltre i componenti di “condizionamento”, che in questo caso sono i prompt di testo che descrivono quale immagine dovrebbe generare il modello. Quindi scaviamo nei componenti del testo.
Il codificatore di testo: un modello di linguaggio trasformatore
Un modello di linguaggio Transformer viene utilizzato come componente di comprensione del linguaggio che accetta il prompt di testo e produce incorporamenti di token. Il modello Stable Diffusion rilasciato utilizza ClipText (un modello basato su GPT ), mentre il documento utilizza BERT .
La scelta del modello linguistico è dimostrata dal documento Imagen come importante. Lo scambio di modelli linguistici più grandi ha avuto un effetto maggiore sulla qualità dell’immagine generata rispetto a componenti di generazione di immagini più grandi.
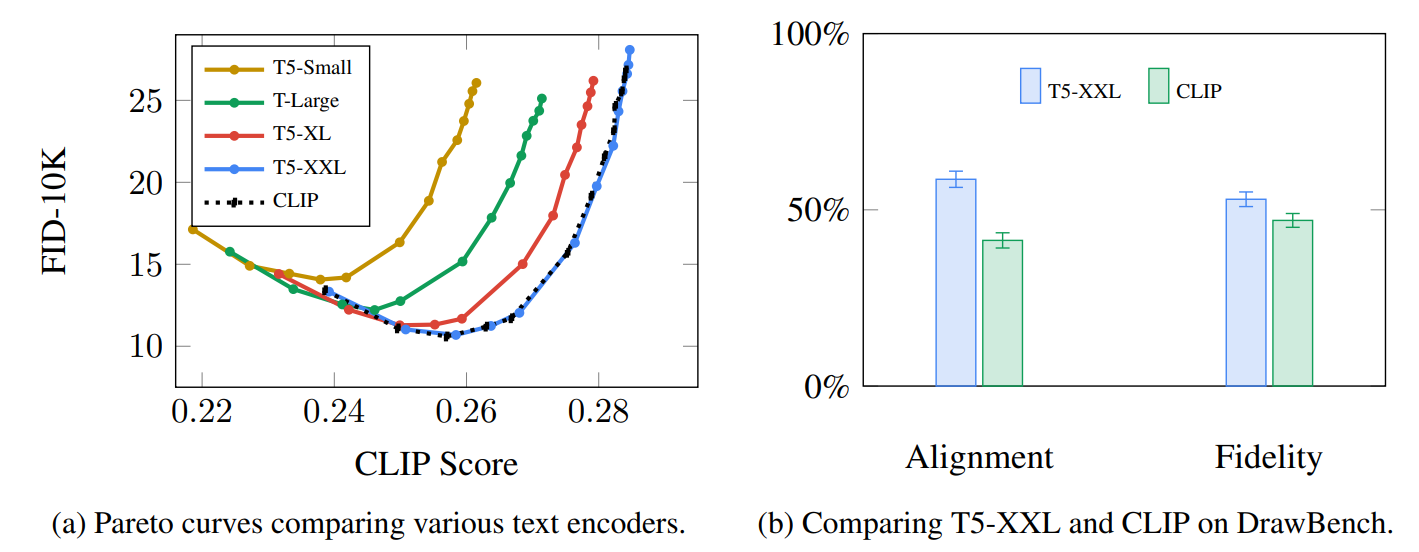
Modelli linguistici più grandi/migliori hanno un effetto significativo sulla qualità dei modelli di generazione delle immagini. Fonte: articolo di Google Imagen di Saharia et. al. . Figura A.5.
I primi modelli Stable Diffusion si limitavano a collegare il modello ClipText pre-addestrato rilasciato da OpenAI. È possibile che i modelli futuri possano passare alle varianti OpenCLIP appena rilasciate e molto più grandi di CLIP (aggiornamento di novembre 2022: abbastanza vero, Stable Diffusion V2 utilizza OpenClip ). Questo nuovo batch include modelli di testo di dimensioni fino a 354 milioni di parametri, a differenza dei 63 milioni di parametri in ClipText.
Come viene addestrato CLIP
CLIP viene addestrato su un set di dati di immagini e relative didascalie. Pensa a un set di dati simile a questo, solo con 400 milioni di immagini e le relative didascalie:
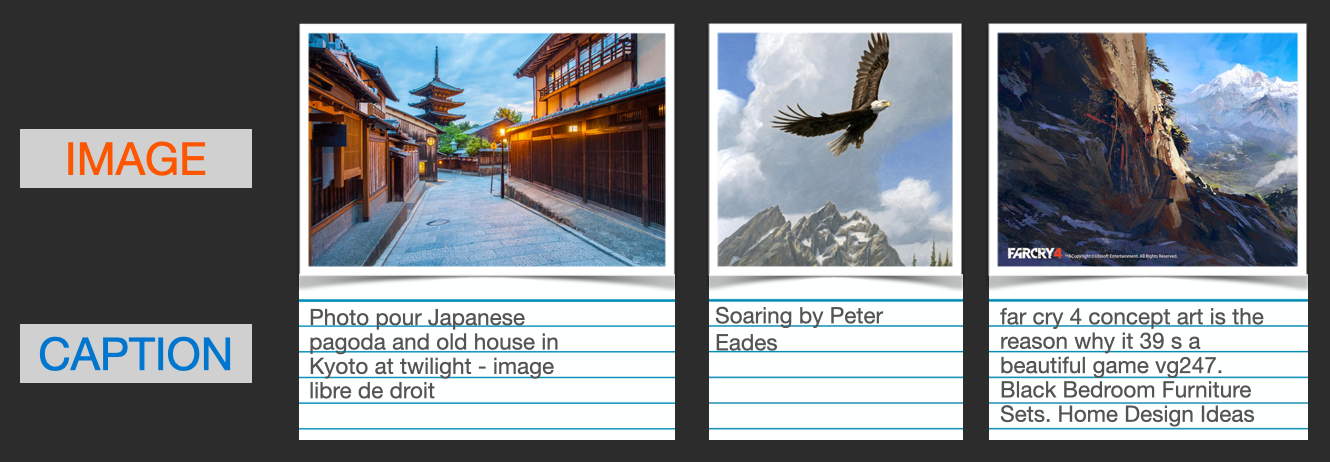
Un set di dati di immagini e relative didascalie.
In realtà, CLIP è stato addestrato su immagini scansionate dal Web insieme ai loro tag “alt”.
CLIP è una combinazione di un codificatore di immagini e un codificatore di testo. Il suo processo di formazione può essere semplificato pensando di prendere un’immagine e la sua didascalia. Li codifichiamo rispettivamente con i codificatori di immagini e testo.
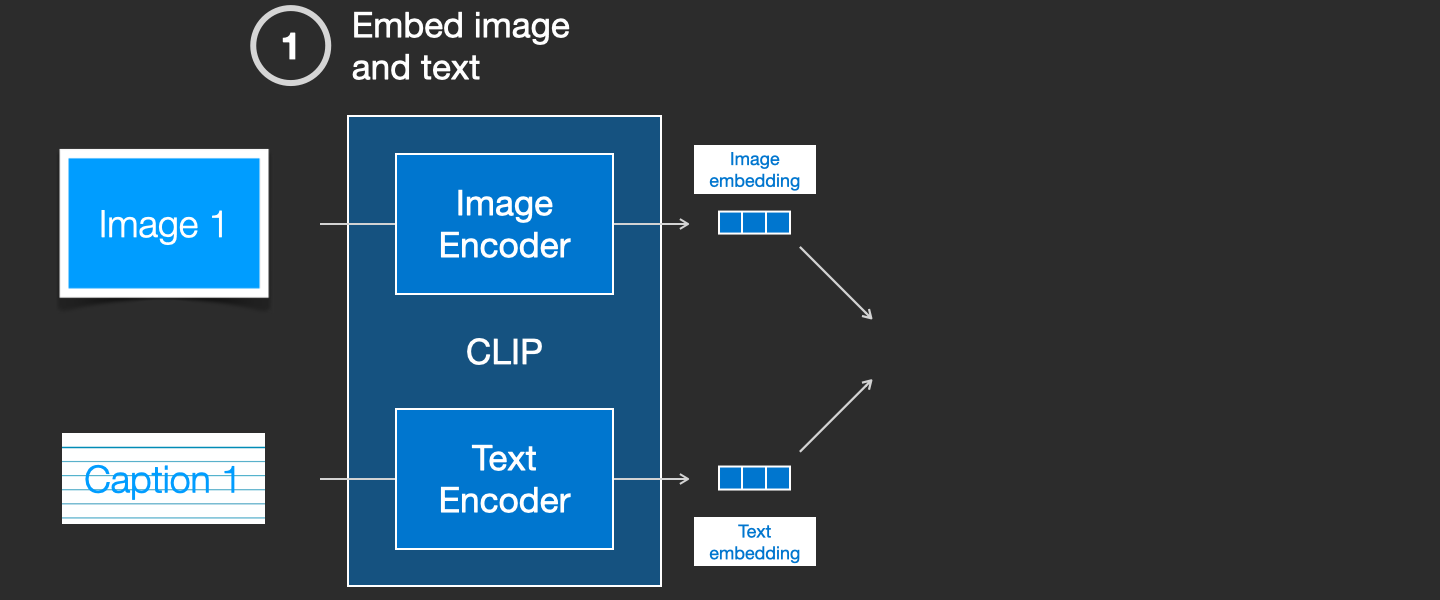
Confrontiamo quindi gli incorporamenti risultanti utilizzando la somiglianza del coseno. Quando iniziamo il processo di formazione, la somiglianza sarà bassa, anche se il testo descrive correttamente l’immagine.
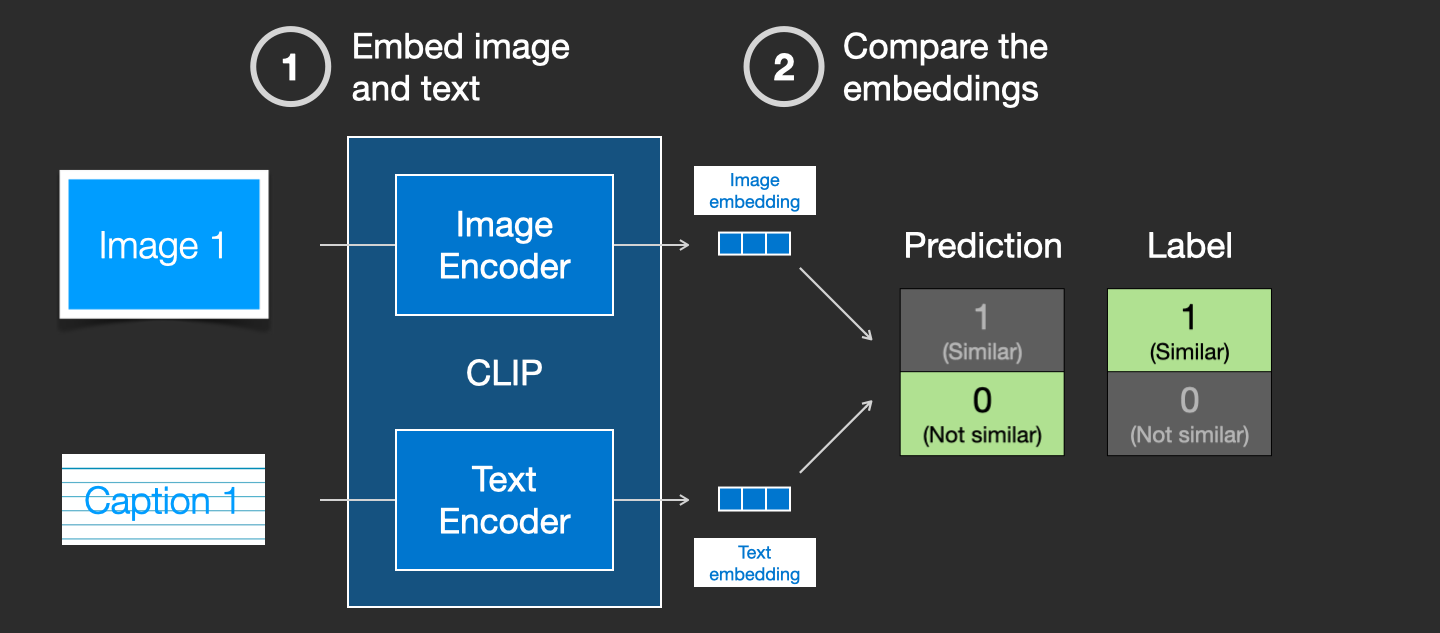
Aggiorniamo i due modelli in modo che la prossima volta che li incorporiamo, gli incorporamenti risultanti siano simili.
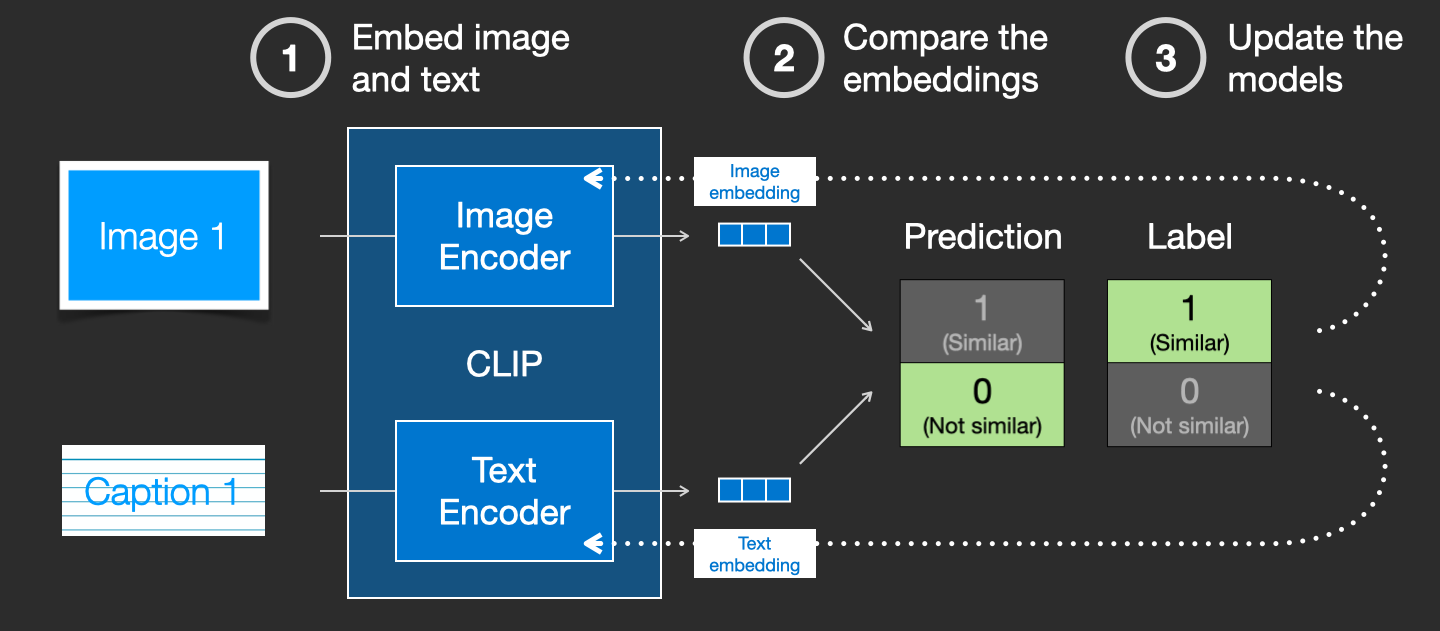
Ripetendo questo in tutto il set di dati e con lotti di grandi dimensioni, finiamo con i codificatori in grado di produrre incorporamenti in cui l’immagine di un cane e la frase “immagine di un cane” sono simili. Proprio come in word2vec , anche il processo di addestramento deve includere esempi negativi di immagini e didascalie che non corrispondono e il modello deve assegnare loro punteggi di somiglianza bassi.
Inserimento di informazioni di testo nel processo di generazione delle immagini
Per rendere il testo una parte del processo di generazione dell’immagine, dobbiamo regolare il nostro predittore di rumore per utilizzare il testo come input.
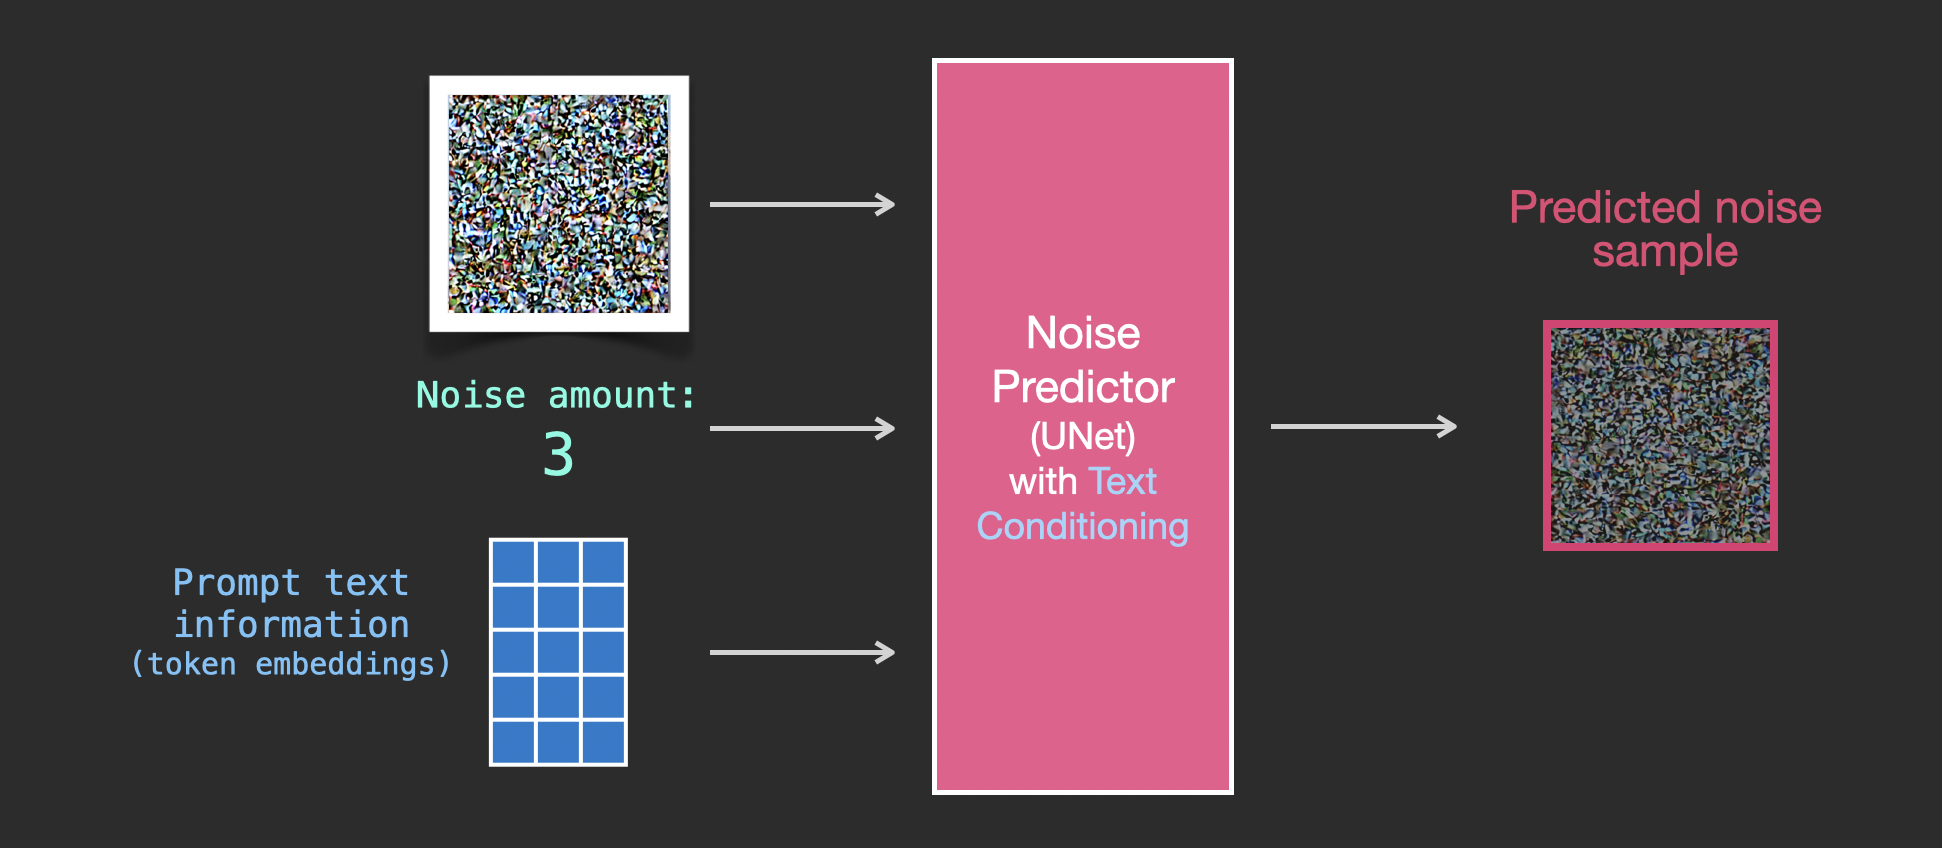
Il nostro set di dati ora include il testo codificato. Poiché operiamo nello spazio latente, sia le immagini di input che il rumore previsto si trovano nello spazio latente.
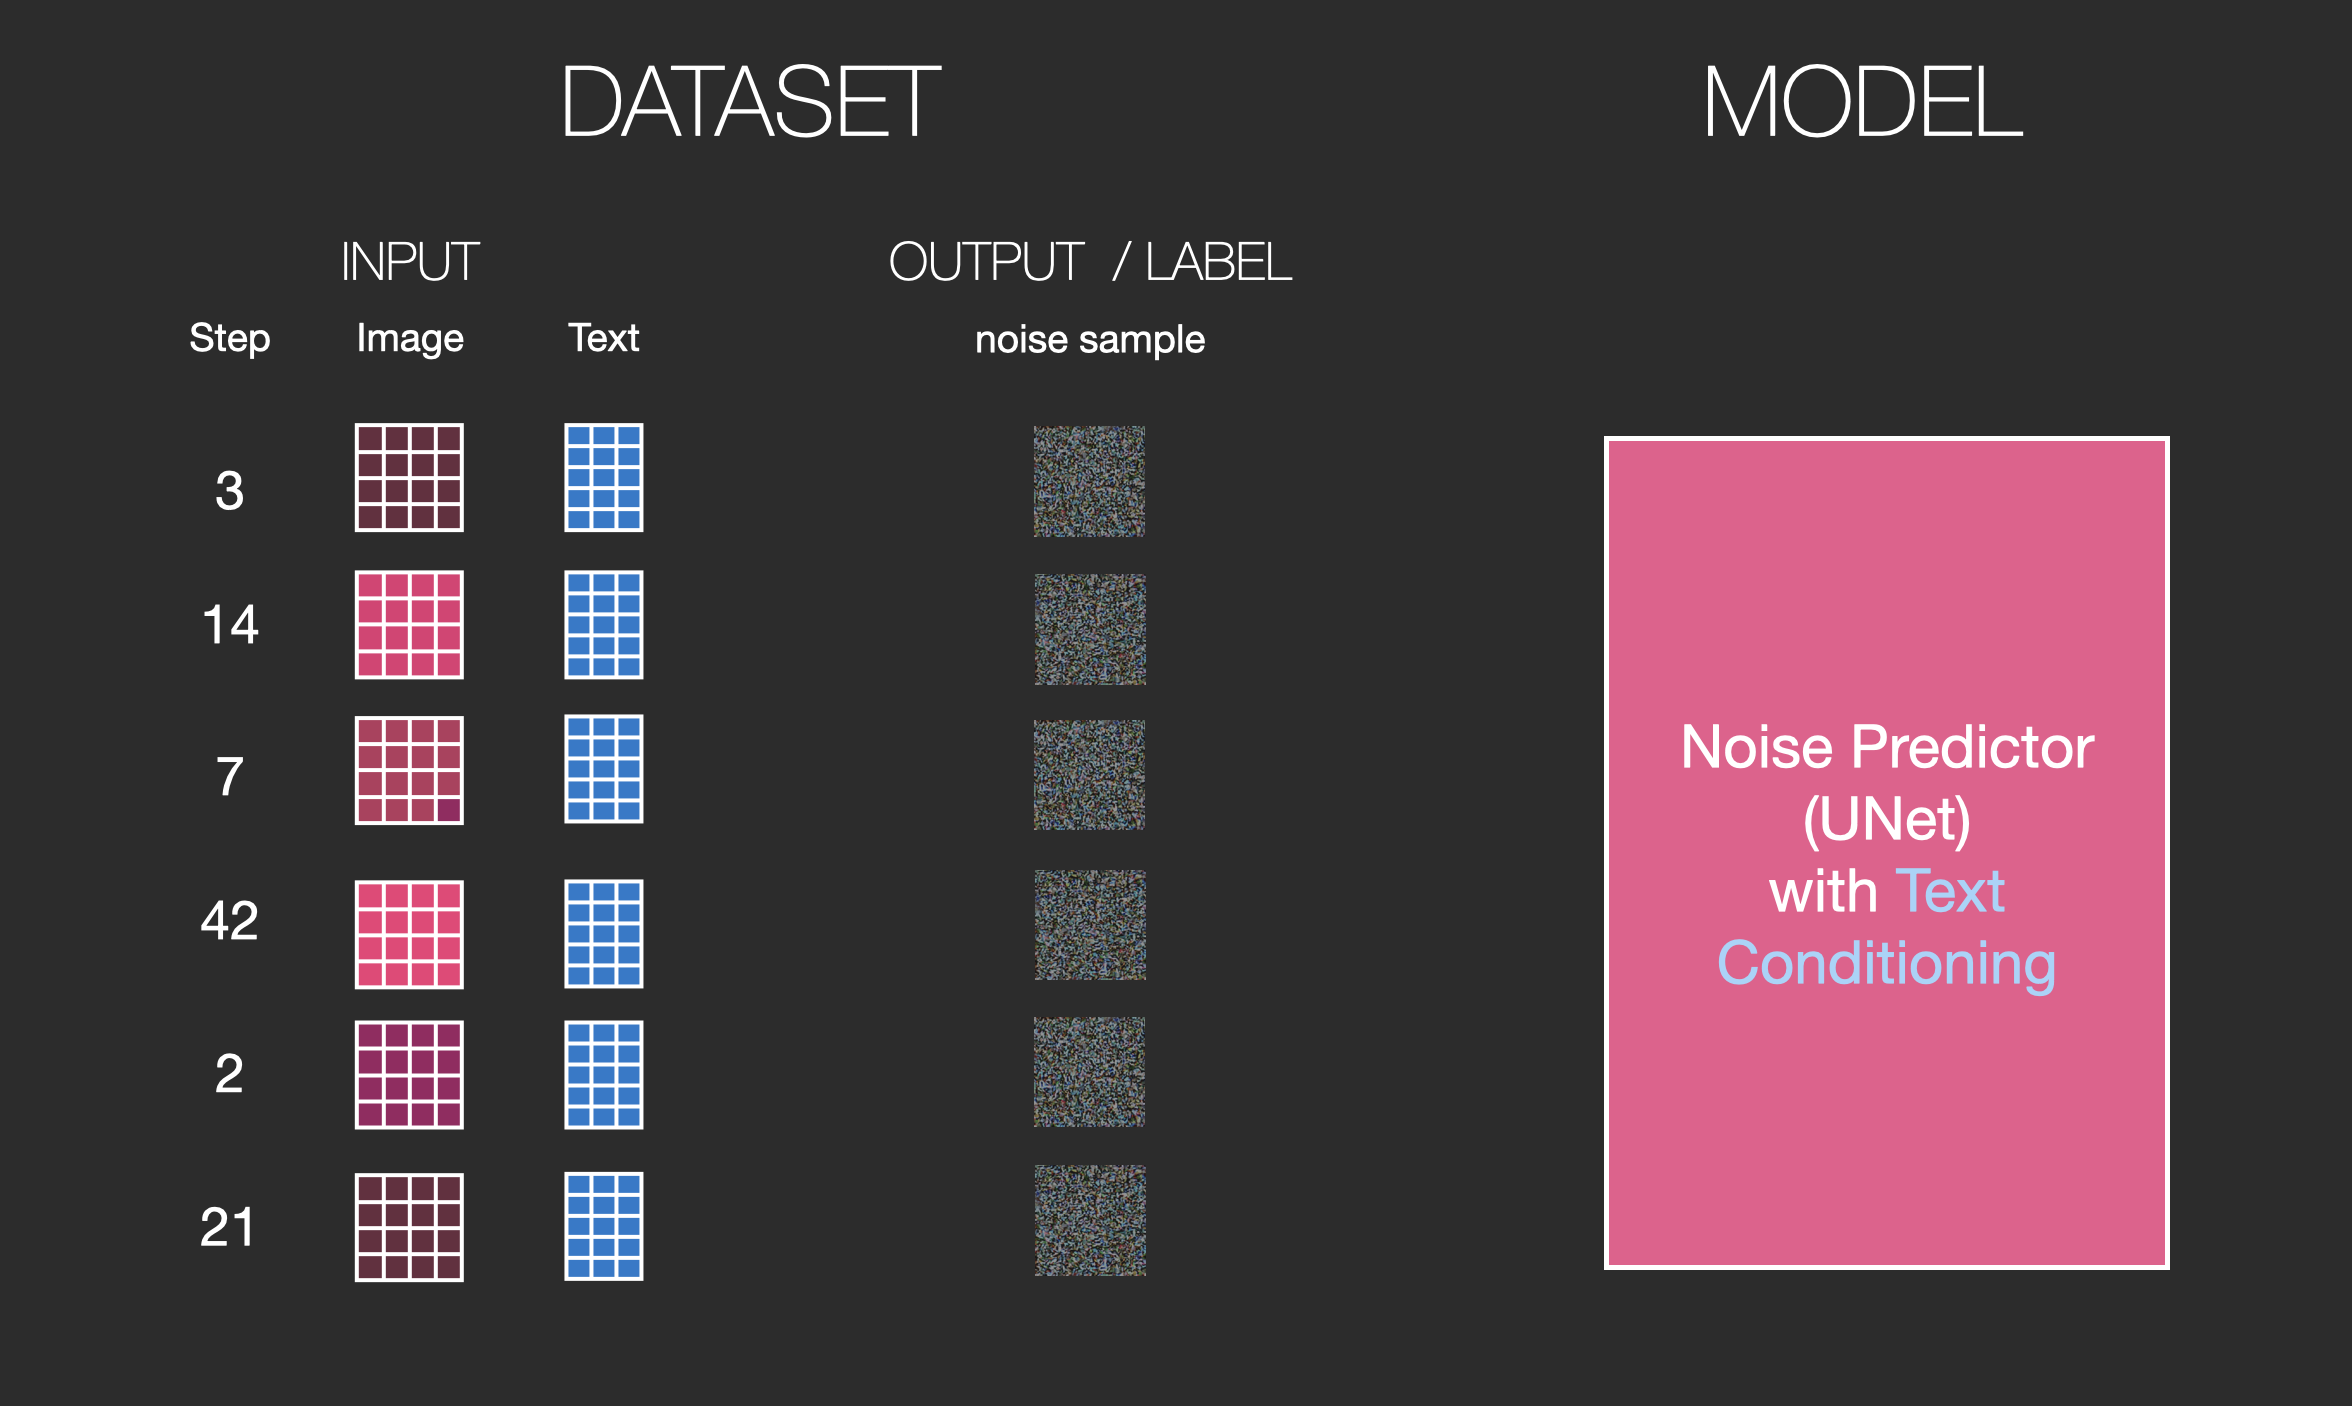
Per avere un’idea migliore di come i token di testo vengono utilizzati in Unet, diamo un’occhiata più in profondità all’interno di Unet.
Livelli del predittore Unet Noise (senza testo)
Diamo prima un’occhiata a un Unet di diffusione che non usa il testo. I suoi input e output sarebbero simili a questo:
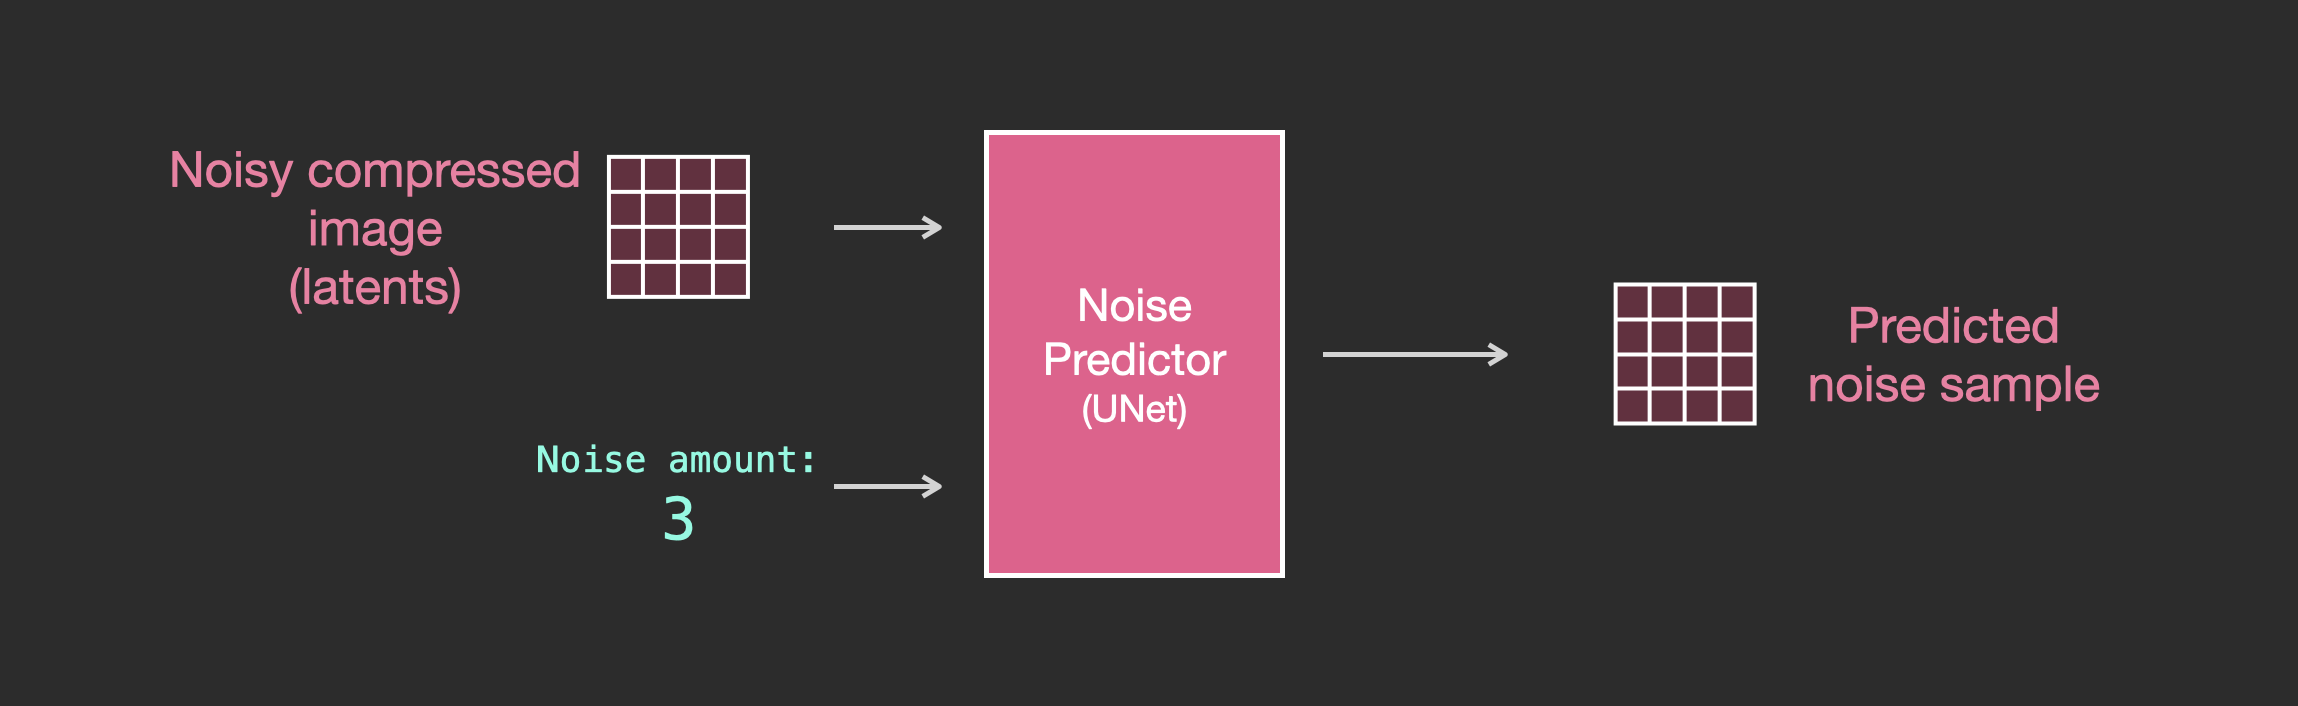
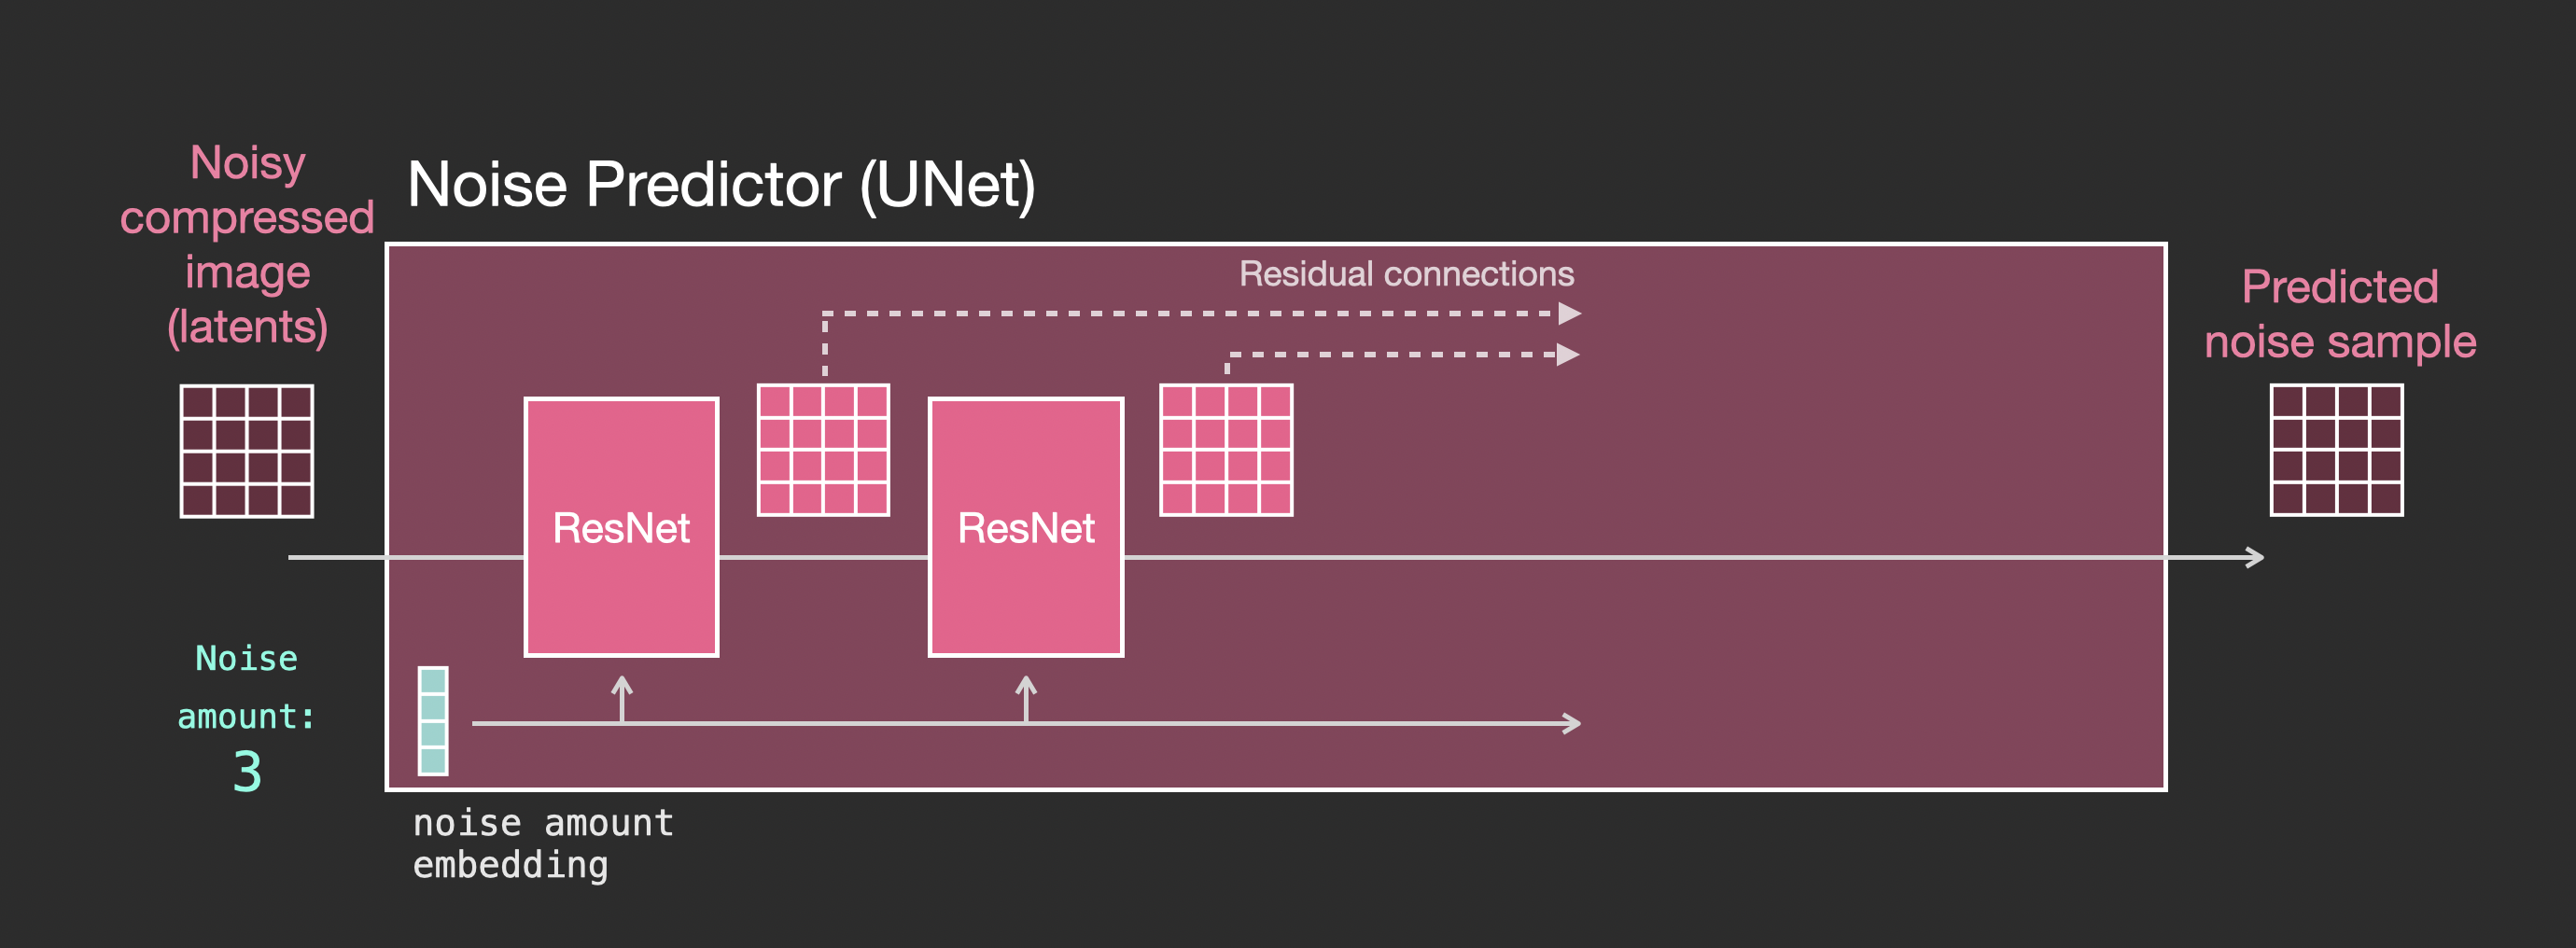
All’interno vediamo che:
- L’Unet è una serie di livelli che lavorano sulla trasformazione dell’array latente
- Ogni livello opera sull’output del livello precedente
- Alcuni degli output vengono immessi (tramite connessioni residue) nell’elaborazione successiva nella rete
- Il passo temporale viene trasformato in un vettore di incorporamento del passo temporale, ed è quello che viene utilizzato nei livelli
Livelli del predittore Unet Noise CON testo
Vediamo ora come modificare questo sistema per includere l’attenzione al testo.
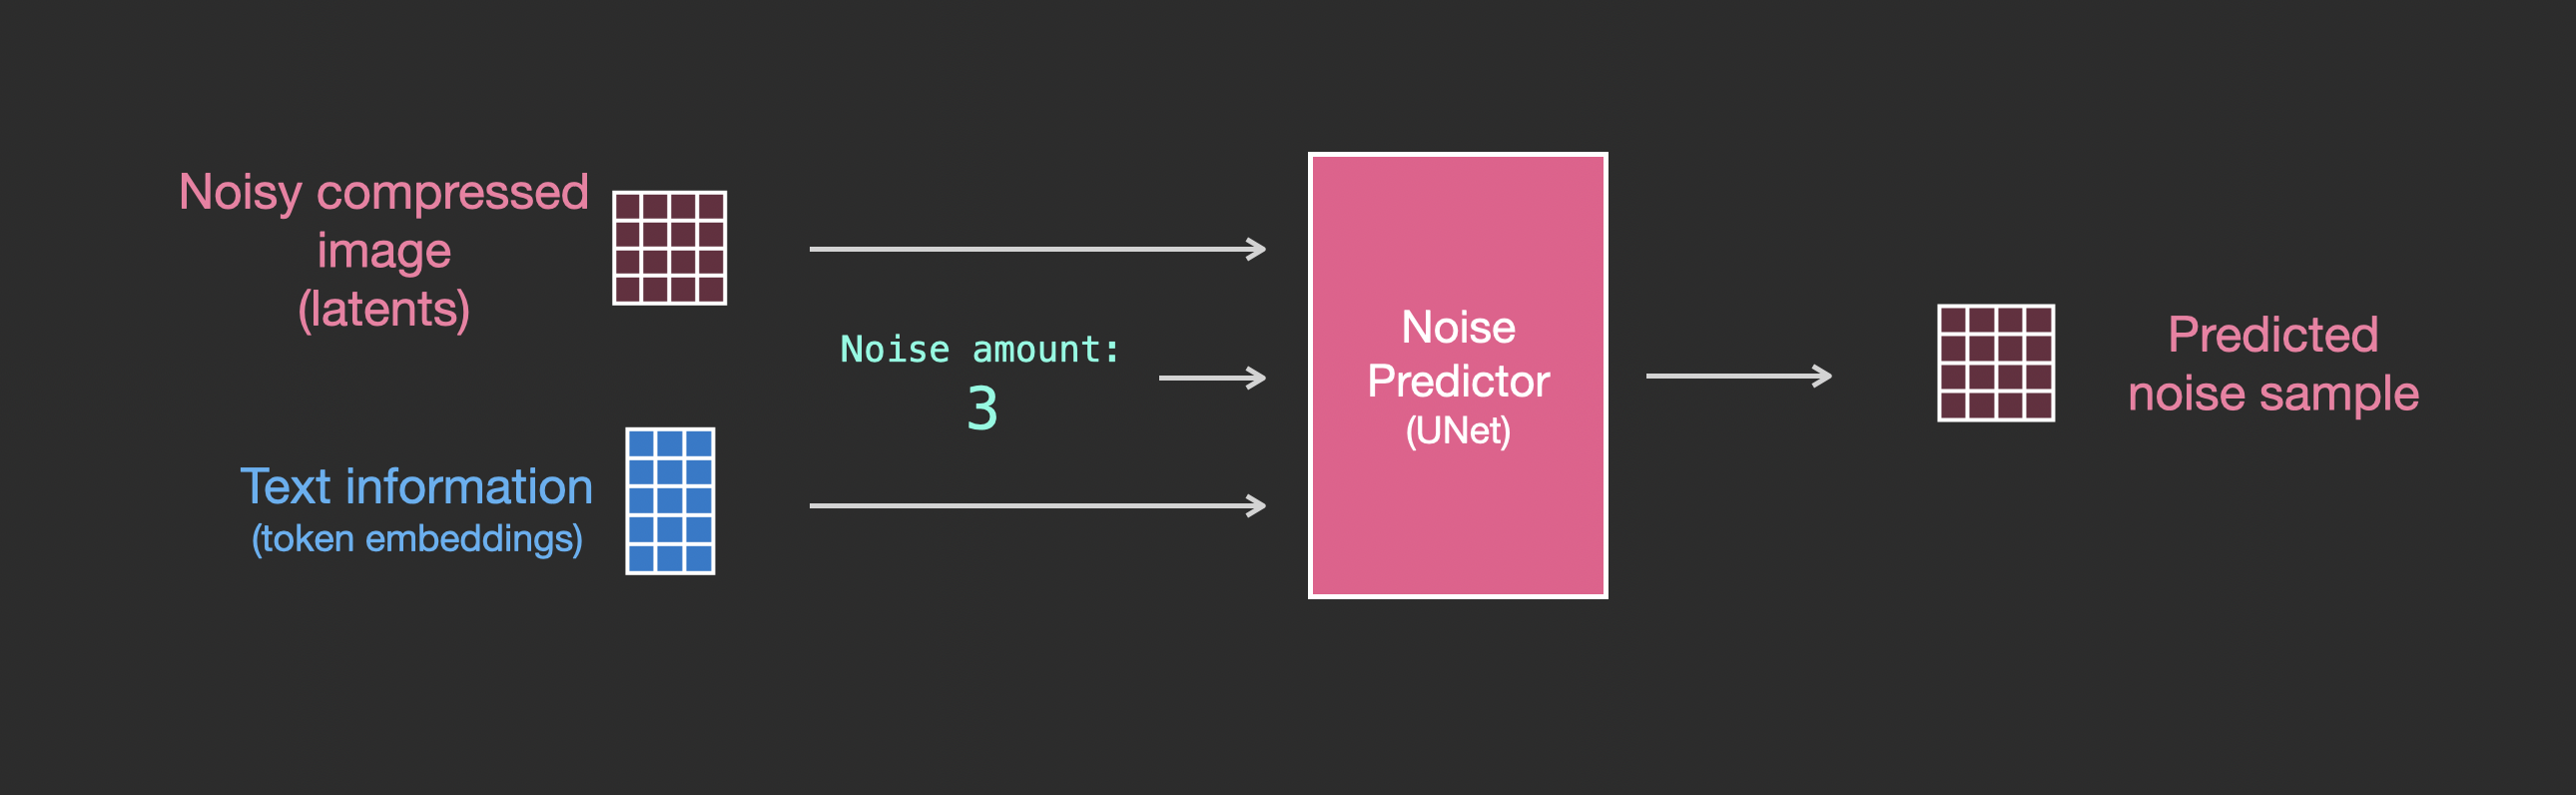
La modifica principale al sistema di cui abbiamo bisogno per aggiungere il supporto per gli input di testo (termine tecnico: condizionamento del testo) è aggiungere un livello di attenzione tra i blocchi ResNet.
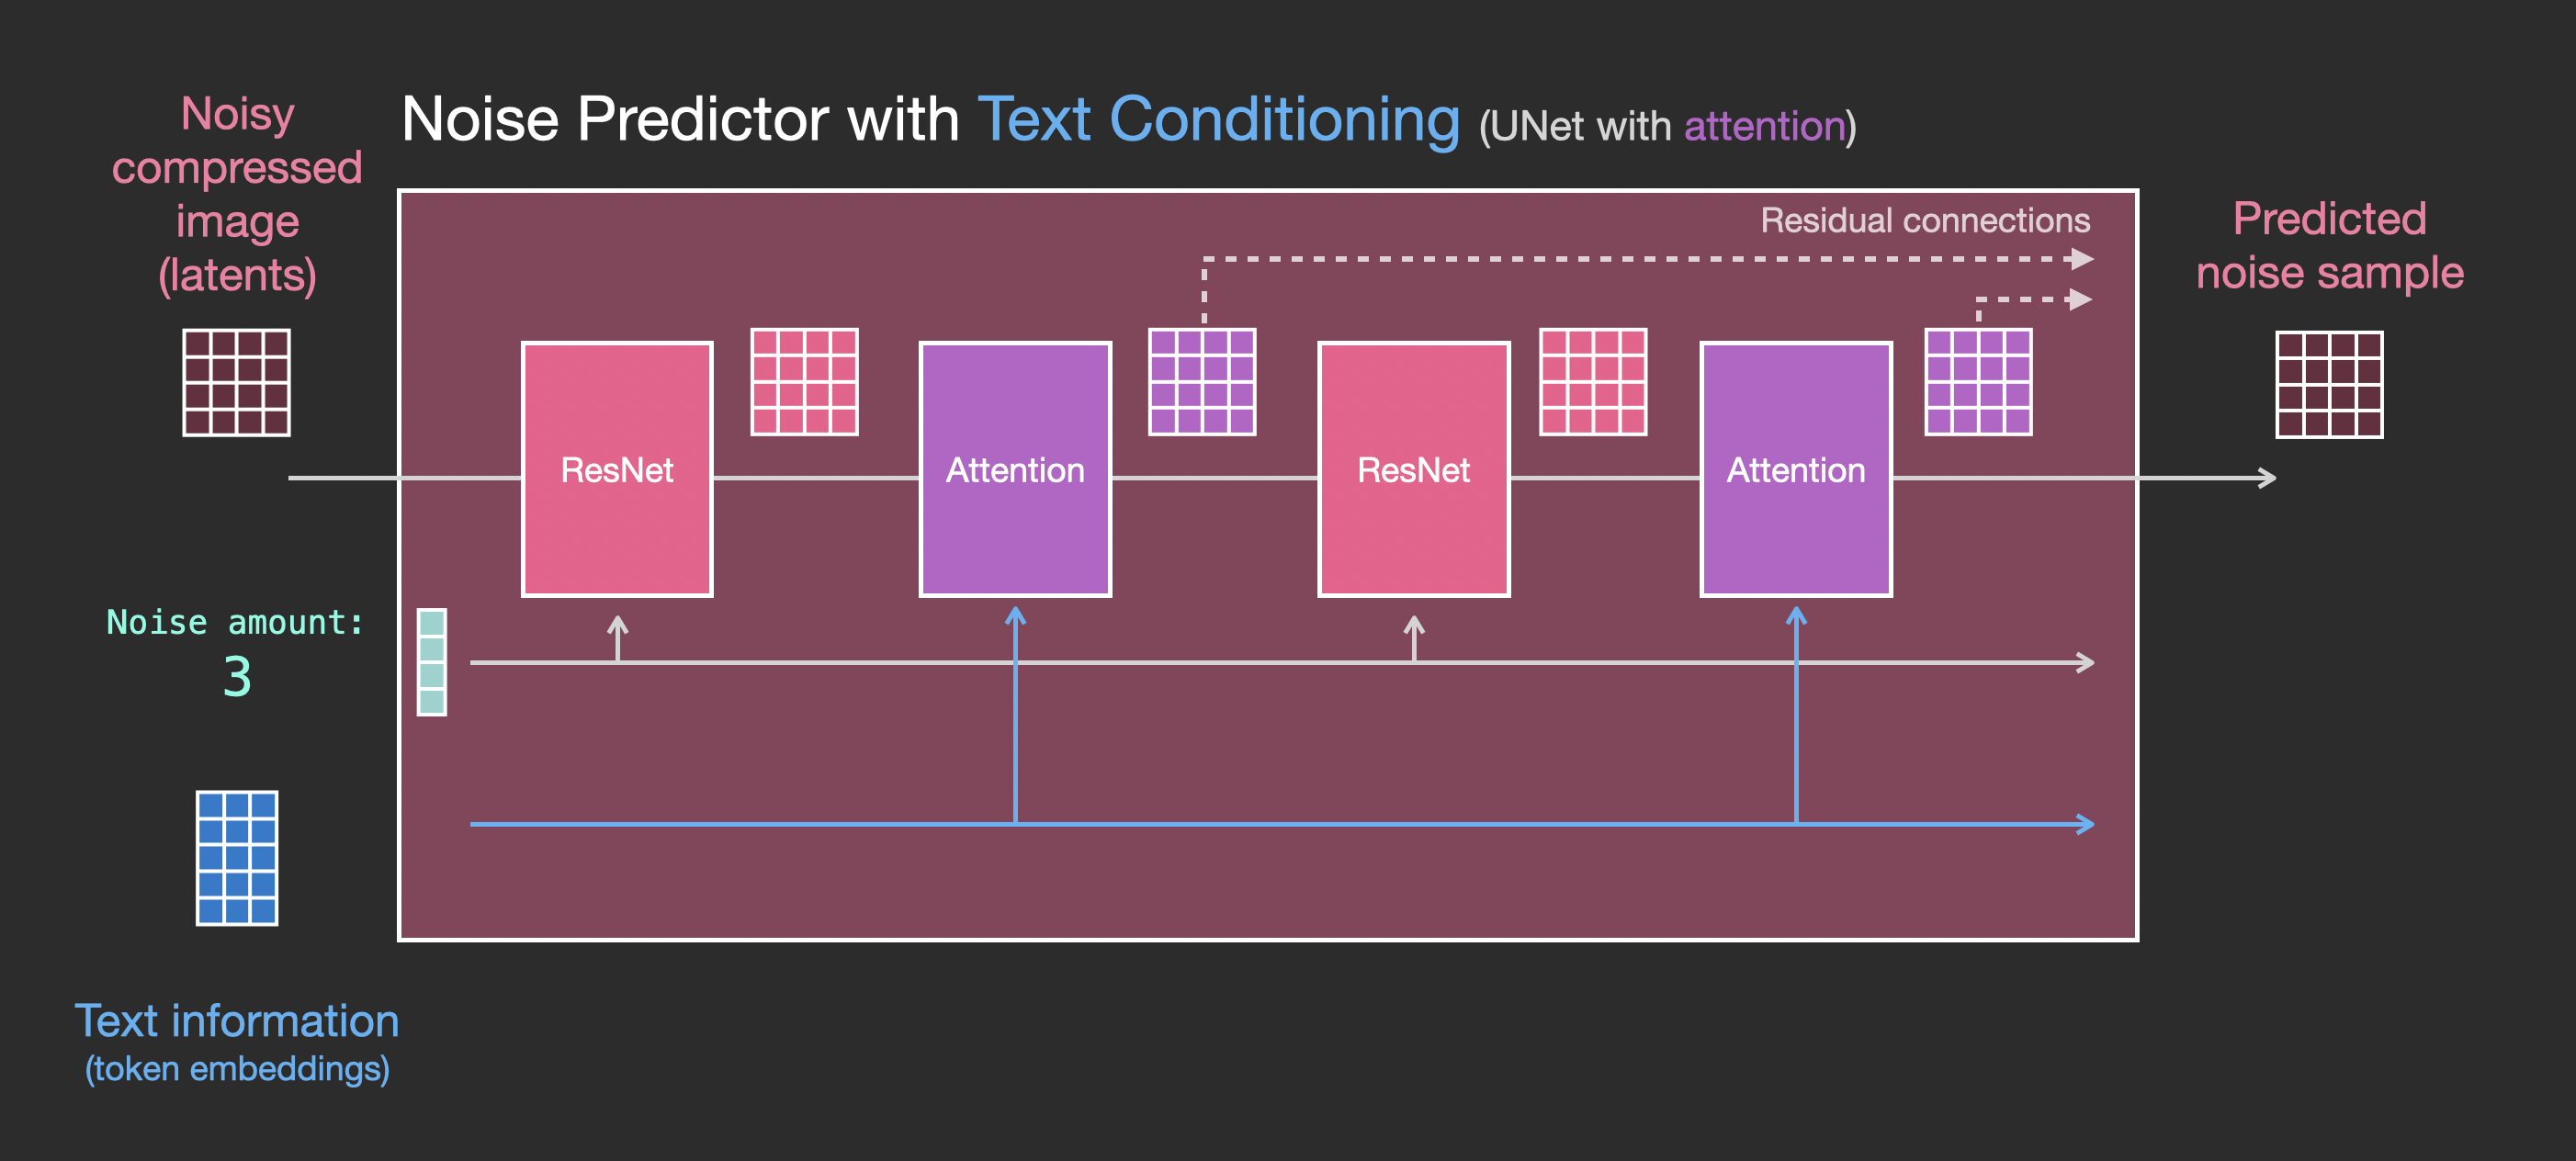
Si noti che il blocco ResNet non guarda direttamente il testo. Ma gli strati di attenzione uniscono quelle rappresentazioni testuali nei latenti. E ora il prossimo ResNet può utilizzare le informazioni di testo incorporate nella sua elaborazione.
Conclusione
Spero che questo ti dia una buona prima intuizione su come funziona Stable Diffusion. Sono coinvolti molti altri concetti, ma credo che siano più facili da capire una volta che hai familiarità con gli elementi costitutivi di cui sopra. Le risorse seguenti sono ottimi passaggi successivi che ho trovato utili. Contattami su Twitter per qualsiasi correzione o feedback.
Risorse
- Ho uno short di YouTube di un minuto sull’utilizzo di Dream Studio per generare immagini con Stable Diffusion.
- Diffusione stabile con 🧨 Diffusori
- Il modello di diffusione annotato
- Come funziona la diffusione stabile? – SPIEGAZIONE DEI MODELLI DI DIFFUSIONE LATENTE [Video]
- Diffusione stabile: cosa, perché, come? [Video]
- Sintesi di immagini ad alta risoluzione con modelli di diffusione latente [The Stable Diffusion paper]
- Per uno sguardo più approfondito agli algoritmi e alla matematica, vedere What are Diffusion Models? di Lilian Weng.
- Guarda i fantastici video di Stable Diffusion da fast.ai
Ringraziamenti
Grazie a Robin Rombach, Jeremy Howard, Hamel Husain, Dennis Soemers, Yan Sidyakin, Freddie Vargus, Anna Golubeva e alla community di Cohere For AI per il feedback sulle versioni precedenti di questo articolo.
Contribuire
Per favore aiutami a migliorare questo articolo. Modi possibili:
- Invia qualsiasi feedback o correzione su Twitter o come Pull Request
- Contribuisci a rendere l’articolo più accessibile suggerendo didascalie e testo alternativo alle immagini (meglio come richiesta pull)
- Traducilo in un’altra lingua e pubblicalo sul tuo blog. Inviami il link e aggiungerò un link qui. I traduttori di articoli precedenti hanno sempre menzionato quanto più profondamente hanno compreso i concetti durante il processo di traduzione.
Discutere
Se sei interessato a discutere della sovrapposizione dei modelli di generazione delle immagini con i modelli linguistici, sentiti libero di postare nel canale #images-and-words nella community di Cohere su Discord . Lì, discutiamo delle aree di sovrapposizione, tra cui:
- mettere a punto i modelli linguistici per produrre buoni prompt per la generazione di immagini
- Utilizzo di LLM per suddividere l’oggetto e i componenti di stile di una richiesta di sottotitoli di immagini
- Image-to-prompt (tramite strumenti come Clip Interrogator )
Citazione
Se hai trovato questo lavoro utile per la tua ricerca, ti preghiamo di citarlo come segue:
@misc{alammar2022diffusion,
  title={The Illustrated Stable Diffusion},
  author={Alammar, J},
  year={2022},
  url={https://jalammar.github.io/illustrated-stable-diffusion/}
}
https://jalammar.github.io/illustrated-stable-diffusion/
